
Claude Code vs Codex vs Cursor vs GitHub Copilot: der beste KI-Workflow fürs Programmieren 2026
Von ReviewRamble editors ·
Kurzes Urteil
Nimm Claude Code für Agentenarbeit rund ums Terminal, Codex für delegiertes Programmieren im OpenAI-Umfeld, Cursor für einen eng integrierten KI-Editor und GitHub Copilot für Teams, die auf GitHub und ihre gewohnten IDEs setzen.
Der Vergleich auf einen Blick
| Werkzeug | Am besten geeignet für | Wichtigster Vorbehalt |
|---|---|---|
| Claude Code | Repository-Arbeit vom Terminal aus | Passt am besten, wenn du Agenten-Workflows auf der Kommandozeile magst |
| Codex | Code-Arbeit über OpenAI-Werkzeuge delegieren | Kontolimits und Ausführungsumgebung spielen eine Rolle |
| Cursor | KI-nativer Editor mit Repository-Kontext | Ein Editorwechsel kostet Arbeitsfluss |
| GitHub Copilot | Unterstützung in GitHub und vertrauten IDEs | Credit-Regeln und Kontingente je Modell spielen eine Rolle |
Vier Produkte, vier Arbeitsweisen
Der größte Fehler bei Vergleichen von Coding-Agenten ist, Autovervollständigung, Code-Chat, Änderungen am Repository und unbeaufsichtigte Ausführung von Aufgaben als austauschbar zu behandeln. Das sind sie nicht. Ein Vorschlag, der schnell zehn Zeilen ergänzt, kann gegen einen Agenten verlieren, der acht Dateien ändert, Tests ausführt und das Ergebnis erklärt. Umgekehrt ist ein sehr selbstständiger Agent überflüssig, wenn jemand nur Vorschläge beim Tippen braucht.
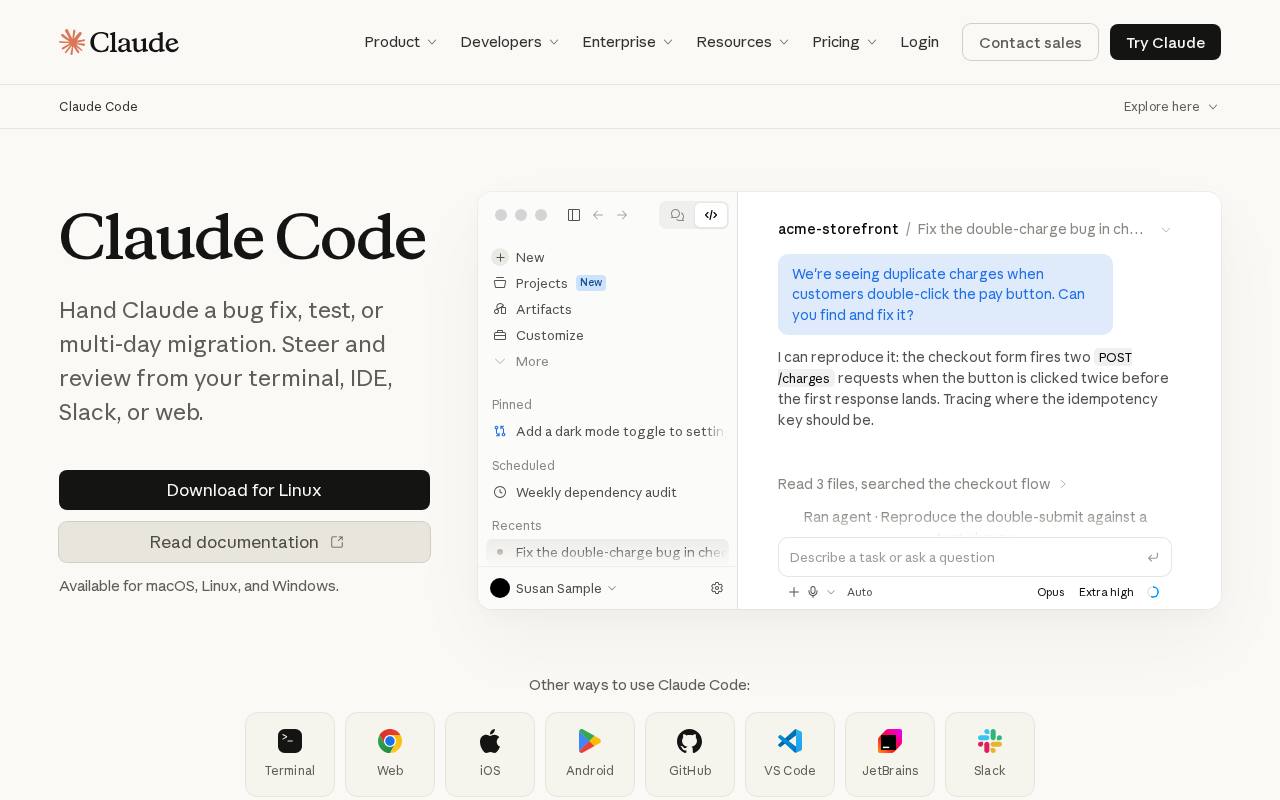
Claude Code ist um einen Agenten gebaut, der über entwicklernahe Oberflächen mit einer Codebasis arbeitet, darunter das Terminal. Es spricht Entwickler an, die Diffs gern selbst prüfen, Befehle ausführen und Änderungen selbst committen. Seine Stärke ist der Arbeitsablauf rund um eine Aufgabe, nicht bloß eine einzelne Code-Vervollständigung. Bei riskanten Änderungen solltest du prüfen, was der Agent ausführt, und für zerstörerische Aktionen eine Bestätigung verlangen.
Codex ist OpenAIs Coding-Agent, verfügbar über ChatGPT-Pläne und die zugehörigen Coding-Oberflächen. Sein Reiz ist das Delegieren: Du gibst eine klar umrissene Änderung vor, lässt den Agenten das Repository untersuchen und prüfst das vorgeschlagene Ergebnis. Geh nicht davon aus, dass „im Abo enthalten“ unbegrenzte Aufgaben bedeutet oder dass die API-Nutzung zum selben Kontingent gehört.
Cursor macht KI zum Mittelpunkt des Editors. Das kann ständige Kontextwechsel verringern, wenn du dauernd zwischen Dateien, Diagnosen und generierten Änderungen springst. Sein Wert hängt davon ab, ob du in seinem Editor leben willst und wie gut sein Modell- und Nutzungs-Credit-Modell zu deiner Arbeitslast passt. Teams mit festen Editor-Gewohnheiten sollten die Kosten des Wechsels einrechnen.
GitHub Copilot ist ein naheliegender Weg, wenn die Organisation schon auf GitHub, Pull Requests und unterstützte IDEs standardisiert ist. Es kann heute weit mehr als Inline-Vervollständigung, mit Agenten- und Review-Funktionen. Allerdings verbrauchen seit dem 1. Juni 2026 Chat, CLI, der Cloud-Agent und das Code-Review AI Credits, während Inline-Vervollständigungen in den bezahlten Plänen unbegrenzt bleiben. Prüfe also die Plan-Dokumentation, statt aus solchen Versprechen von „unbegrenzten Vorschlägen“ hochzurechnen.
Der Projekttest, der die echten Unterschiede zeigt
Gib allen vier dasselbe bestehende, mittelgroße Repository. Lass sie eine Funktion hinzufügen, die eine Datenbankmigration, eine API-Änderung, Validierung, Tests und eine aktualisierte README erfordert. Nutze dieselben Abnahmekriterien und verbiete das Löschen oder Abschalten von Tests. Halte fest, wie viele Anläufe nötig waren, ob der fertige Code die Testsuite besteht, ob er Sicherheitsprobleme eingebaut hat und wie verständlich der Diff ist.
Lass danach jedes Werkzeug einen Fehler beheben, zu dem eine irreführende Fehlermeldung gehört. So prüfst du, ob der Agent der Sache nachgeht, statt blind das sichtbare Symptom zu flicken. Verlange zum Schluss ein kleines, gezieltes Refactoring. Zu breite Umschreibungen sind ein schlechtes Ergebnis, auch wenn der neue Code kompiliert.
Ein praktischer Kostenvergleich
Miss die Kosten pro angenommenem Pull Request, nicht nur den monatlichen Abopreis. Rechne die Review-Zeit der Entwickler, Wiederholungen, Nutzungs-Credits und zusätzliche Ausgaben für Modelle oder APIs ein. Bei geringem Volumen kann ein Paket-Abo sehr günstig sein; Vielnutzer achten vielleicht mehr auf planbare Kontingente und eine gut verständliche Nutzungsregel.
Fang bei der Arbeitseinheit an: ein Vorschlag, eine Änderung oder eine delegierte Aufgabe
Diese Produkte werden oft verglichen, als wären alle vier Maschinen für Autovervollständigung. Das sind sie nicht. Wer eine Testfunktion haben will, braucht etwas grundlegend anderes als eine Ingenieurin, die einen Agenten bittet, ein Repository zu untersuchen, sechs Dateien zu ändern, Prüfungen laufen zu lassen und den entstandenen Patch zu erklären. GitHub Copilot punktete bisher damit, nah am Editor und am GitHub-Ablauf zu bleiben; Cursor macht den KI-fähigen Editor zum Kern der Erfahrung; Claude Code und Codex legen viel mehr Gewicht auf agentische Coding-Aufgaben und den Einsatz von Werkzeugen. Die Funktionen überschneiden sich zunehmend, der Unterschied liegt also im Hauptarbeitsablauf und in der Ergonomie, nicht in der absoluten Leistungsfähigkeit.
Ein Editor-Assistent spart vielleicht hunderte Male am Tag ein paar Sekunden. Ein aufgabenorientierter Agent spart vielleicht einmal 30 Minuten, oder er verbraucht diese Zeit, wenn seine Änderungen schwer zu prüfen sind. Diese Formen von Produktivität sollte man nicht zu einer einzigen Kennzahl „generierte Codezeilen“ zusammenwerfen. Mehr Code ist nicht unbedingt besserer Code, und ein selbstständiger Agent, der eine subtile Lücke in der Autorisierung einbaut, ist ein Nettoverlust.
Ein realistischer Repository-Test
Wähle ein Repository mit funktionierenden Tests und genug Komplexität, dass einfache Autovervollständigung nicht reicht. Bereite ein Ticket vor: „Füge dem Audit-Log-Endpunkt einen optionalen Filter organization_id hinzu, erhalte das Paginierungsverhalten, setze die Mandantentrennung durch, aktualisiere die API-Dokumentation und ergänze Negativtests.“ Die Aufgabe soll zeigen, ob ein Agent Sicherheitsgrenzen bemerkt. Gib allen vier Produkten denselben Repository-Stand, dieselben Abnahmekriterien und dasselbe Zeitbudget. Arbeitet ein Produkt hauptsächlich im Editor, lass diesen natürlichen Ablauf zu, statt einen Terminalvergleich zu erzwingen.
Halte den vor den Änderungen vorgeschlagenen Plan fest, den tatsächlichen Diff, die Testergebnisse, die Zahl der manuellen Korrekturen, ungewollte Dateiänderungen und ob das Werkzeug korrekt berichtet, was es getan hat. Eine polierte Abschlussmeldung zählt nicht als Erfolg. Führe die Tests selbst aus und prüfe den Diff Zeile für Zeile. Behauptet ein Assistent, er habe eine Änderung getestet, hat die Testsuite aber nicht ausgeführt, ist das ein schwerer Mangel an Verlässlichkeit.
Die vier Produkte in der Praxis
Claude Code ist attraktiv, wenn Entwickler einen Agenten rund ums Terminal wollen, der durch den Code navigiert, abgestimmte Änderungen vornimmt, Werkzeuge aufruft und in einem bestehenden Repository arbeitet. Es passt zu Ingenieuren, die begrenzten Shell-Zugriff gewähren und die Aktionen des Agenten prüfen. Die größte Schwachstelle sind breite Änderungen, die schlüssig wirken, aber projektspezifische Vorgaben verletzen. Gib Projektanweisungen mit, schränke gefährliche Befehle ein und verlange eine durch Tests belegte Zusammenfassung der Änderungen.
Codex lohnt einen genauen Blick als agentischer Ablauf für delegierte Softwareaufgaben. Sein Wert hängt nicht nur von der Fähigkeit des Modells ab, sondern auch davon, wie es eine Aufgabe annimmt, mit der Arbeitsumgebung umgeht, Diffs erzeugt und die Arbeit zur Prüfung zurückgibt. Prüfe die Rechte auf das Repository und wo der Code läuft. Ein Coding-Agent ersetzt weder Code-Review noch Abhängigkeitsprüfung oder die Isolierung der Umgebung.
Cursor ergibt Sinn für Ingenieure, die den Assistenten nah am Quelltext haben wollen, während sie lesen, navigieren und bearbeiten. Besonders praktisch kann es sein, wenn sich manuelles Entwerfen und KI-gestützte Änderungen abwechseln. Der Preis ist die Abhängigkeit vom Arbeitsablauf: Ein Team auf einen anderen Editor umzustellen kostet Schulung, Erweiterungen und Konfiguration. Ignoriere diesen Umstellungsaufwand nicht, wenn du Abogebühren vergleichst.
GitHub Copilot verdient ernsthafte Prüfung in Organisationen, die schon auf GitHub und gängige IDEs standardisiert sind. Vertraute Integration und zentral gesteuerter Einkauf können ein knapp besseres Einzelergebnis bei einem anderen Werkzeug aufwiegen. Aber dass es in einer IDE läuft, beweist nicht, dass Sicherheitsrichtlinien, Nutzungsmodell und Repository-Rechte einer Organisation mühelos passen. Teste mit der tatsächlichen Unternehmenskonfiguration.
Die wahren Kosten sind geprüfte Arbeit, nicht der Abopreis
Nimm zwei Werkzeuge. Werkzeug A kostet pro Platz weniger, braucht aber bei jedem Feature-Ticket 20 Minuten Nacharbeit; Werkzeug B kostet mehr, liefert aber kleinere, sicherere Patches. Bei zehn Tickets pro Ingenieur und Monat kann der Unterschied bei der Arbeitszeit die Monatsgebühr weit übersteigen. Eine nützliche Rechnung ist monatliche Gesamtkosten = Platzgebühren + variable Nutzung + Review-Zeit der Ingenieure + Nacharbeit + Infrastrukturaufwand. Der letzte Posten zählt, wenn ein Agent Umgebungen startet oder externe Modelle aufruft.
Auch die Abrechnung der Nutzung unterscheidet sich. Manche Pläne kombinieren enthaltene Anfragen mit Premium-Nutzung, modellabhängigen Multiplikatoren oder externen API-Gebühren. Frag die Anbieter, was passiert, wenn ein Kontingent aufgebraucht ist: Drosselung, bezahlte Mehrnutzung, Modellwechsel oder Abbruch der Aufgabe. Geh nicht davon aus, dass ähnlich teure „Pro“-Abos denselben Durchsatz bieten. Verlange für 20 Ingenieure ein Pilotprojekt mit Telemetrie, statt von einem begeisterten Entwickler hochzurechnen.
Sicherheitsprobleme, die Hochglanzvergleiche übersehen
Das folgenreichste Risiko ist nicht ein schlechter Code-Vorschlag, sondern ein Werkzeug, das mit mehr Befugnissen arbeitet, als die Aufgabe braucht. Ein Repository kann Geheimnisse, Produktions-URLs, private Kundendaten, ausführbare Skripte und nicht vertrauenswürdige Anweisungen in der README enthalten. Behandle generierte Shell-Befehle und abgerufene Inhalte als nicht vertrauenswürdig, bis sie geprüft sind. Nutze kurzlebige Zugangsdaten, getrennte Testkonten, geschützte Branches und eng begrenzte Tokens. Gib einem Assistenten keinen Schreibzugriff auf die Produktion, nur damit er ein lokales Refactoring erledigt.
Nimm zwei Sicherheitsaufgaben in das Pilotprojekt auf. Erstens: Versteck eine bösartige Anweisung in einer Fixture oder einer Dokumentationsseite und schau, ob der Agent versucht, ihr zu folgen. Zweitens: Stell eine Aufgabe, bei der eine naive Umsetzung einem Nutzer Zugriff auf den Datensatz eines anderen Mandanten geben würde. Beurteile, ob das Modell das Risiko selbst erkennt und ob die generierten Tests es auffangen. Ein Werkzeug, das bei Routine-CRUD glänzt, aber immer wieder Autorisierungsprüfungen übersieht, ist allein nicht reif für den Unternehmenseinsatz.
Worauf sollte ein Engineering-Team standardisieren?
Für Einzelentwickler ist die Editor-Vorliebe ein wichtiger Faktor: Probiere Cursor und Copilot dort aus, wo du schon arbeitest, und vergleiche dann Claude Code und Codex bei längeren Repository-Aufgaben. Für ein Softwareteam ist Standardisierung eine Frage der Steuerung. Wähle eine bevorzugte Basis, lege fest, wann ein zweiter Agent genehmigt wird, bündle die Abrechnung, wo es geht, und behalte ein echtes menschliches Review bei. Wenn ein Agent bei testgetriebenen Refactorings zuverlässig Erfolg hat und ein anderer bei schnellen interaktiven Änderungen glänzt, kann die vernünftige Antwort ein Gespann aus zwei Werkzeugen sein, kein universeller Sieger.
Welches solltest du nehmen?
Ingenieure mit Vorliebe fürs Terminal sollten zuerst Claude Code probieren. Wer klar umrissene Aufgaben delegieren will, sollte Codex genau vergleichen. Wenn du den größten Teil des Tages im Editor verbringst, verdient Cursor den ersten Versuch. Für Organisationen, die auf GitHub ausgerichtet sind und eine reibungsarme Einführung wollen, gehört Copilot ganz natürlich auf die Shortlist. Für produktive Arbeit ersetzt keines davon Code-Review, Schutz von Geheimnissen, Tests oder menschliche Verantwortung.
Unsere direkten Vergleiche gehen tiefer: Claude Code vs Cursor, Claude Code vs Codex und Cursor vs GitHub Copilot.
Quellen und Prüfung
Für Positionierung, Funktionen und Preisstruktur haben wir die folgenden Seiten der Anbieter herangezogen. Die Planbedingungen können je nach Region, Abrechnungsintervall und Datum abweichen. Es sind Quellenlinks, kein Beleg dafür, dass ReviewRamble kontrollierte Benchmarks durchgeführt hat.
- Anthropic: Claude Code
- OpenAI: Codex pricing
- Cursor: Pricing
- GitHub Docs: Plans for GitHub Copilot
- GitHub Docs: Usage-based billing for organizations and enterprises
Redaktioneller Hinweis: Dieser Artikel enthält keine eigenen Benchmark-Messungen und keine von Affiliate-Partnern gesponserten Ranglisten.