
Mémoire de Claude Code ou wiki en Markdown : où s'arrête chacun
Par ReviewRamble editors ·
La mémoire de Claude Code est un ensemble de notes que le modèle lit, pas un ensemble de règles qu'il doit respecter. CLAUDE.md contient vos instructions, Auto Memory contient ce que Claude a appris sur vous, et ni l'un ni l'autre ne peut arrêter une action. Quand le travail s'étend à de nombreuses sources que vous voulez conserver, citer et vérifier, un wiki en Markdown est la meilleure forme, et les hooks qui le remplissent automatiquement sont une option à ajouter en dernier, avec prudence.
Cet article trace la frontière entre ces couches. Chaque affirmation sur Claude Code vient de la documentation d'Anthropic sur la mémoire, les hooks et l'Agent SDK ; le modèle de wiki vient du gist LLM Wiki d'Andrej Karpathy, et l'automatisation du README de claude-memory-compiler. Nous n'avons pas fait tourner ces configurations nous-mêmes.
CLAUDE.md : les instructions que vous écrivez
CLAUDE.md est un fichier Markdown que vous écrivez et que Claude Code lit au début de chaque session. Il peut se trouver dans un projet, dans votre dossier personnel ou au niveau de l'organisation, et il peut intégrer d'autres fichiers avec des imports @path, jusqu'à quatre niveaux de profondeur. Anthropic conseille de garder chaque fichier sous 200 lignes, car les fichiers longs prennent plus de contexte et sont suivis moins fidèlement, et propose .claude/rules/ pour les instructions qui ne concernent que certains types de fichiers.
Voyez-le comme les consignes que vous donneriez à un nouveau collègue : commandes de build, style maison, le dossier auquel personne ne doit toucher. Ce n'est pas l'endroit pour une pile de faits qui grossit.
Auto Memory : les notes que Claude garde pour lui
Auto Memory est activée par défaut dans les sessions locales. Claude écrit ses propres notes en travaillant, à partir de vos corrections et de vos préférences, dans ~/.claude/projects/<project>/memory/. Un fichier MEMORY.md les indexe, une ligne par souvenir, et chaque souvenir a son propre fichier thématique. Seules les 200 premières lignes ou les premiers 25KB de MEMORY.md, selon la limite atteinte en premier, sont chargés au début d'une session ; les fichiers thématiques sont lus quand Claude juge en avoir besoin.
Deux détails comptent. La mémoire reste sur la machine : elle ne vous suit pas sur un autre ordinateur ni dans une session cloud. Et c'est du Markdown brut : vous pouvez ouvrir /memory, lire ce que Claude a conclu à votre sujet et supprimer ce qui est faux. Vous pouvez la désactiver par projet en mettant autoMemoryEnabled à false.
Du contexte, pas une contrainte
La page d'Anthropic sur la mémoire le dit sans détour : Claude traite CLAUDE.md et Auto Memory comme du contexte, pas comme une configuration imposée. Une ligne disant "ne supprime jamais le dossier des migrations" est un conseil que le modèle suit en général. Si deux instructions se contredisent, la documentation prévient que Claude peut en choisir une arbitrairement.
Ce qui bloque vraiment une action, c'est un hook PreToolUse. Il s'exécute avant l'appel d'un outil, et s'il se termine avec le code 2, ou renvoie un permissionDecision à deny, Claude Code arrête l'appel. Le partage est donc simple : les préférences vont dans la mémoire, et tout ce qui ne doit jamais arriver va dans un hook ou dans les réglages de permissions.
Là où un wiki prend le relais
La mémoire répond à "comment j'aime travailler". Elle est mauvaise pour "que disent ces quarante articles, comptes rendus de réunion et pages de fournisseurs, et d'où vient chaque affirmation". C'est le rôle du modèle LLM Wiki de Karpathy, publié en avril 2026 comme un fichier d'idées à coller dans votre propre agent.
Il comporte trois couches. Un dossier raw/ contient vos sources, que le modèle lit mais ne modifie jamais, si bien qu'elles restent la référence. Un dossier wiki/ contient des pages Markdown que le modèle écrit et entretient : résumés, pages sur des personnes et des concepts, comparaisons. Un fichier de schéma, CLAUDE.md pour Claude Code, fixe la structure et les étapes pour ajouter une source, répondre à une question et faire le ménage. Deux fichiers le rendent navigable : index.md liste chaque page avec un lien et un résumé d'une ligne, et log.md est un journal auquel on ne fait qu'ajouter, avec chaque ingestion, requête et vérification.
C'est le ménage qui transforme des notes en connaissances fiables. Karpathy appelle cela le lint : un passage périodique qui cherche les contradictions entre pages, les affirmations remplacées par une source plus récente, les pages vers lesquelles rien ne pointe, les concepts qui méritent leur propre page et les renvois manquants. Une seule nouvelle source, note-t-il, peut toucher 10 à 15 pages.
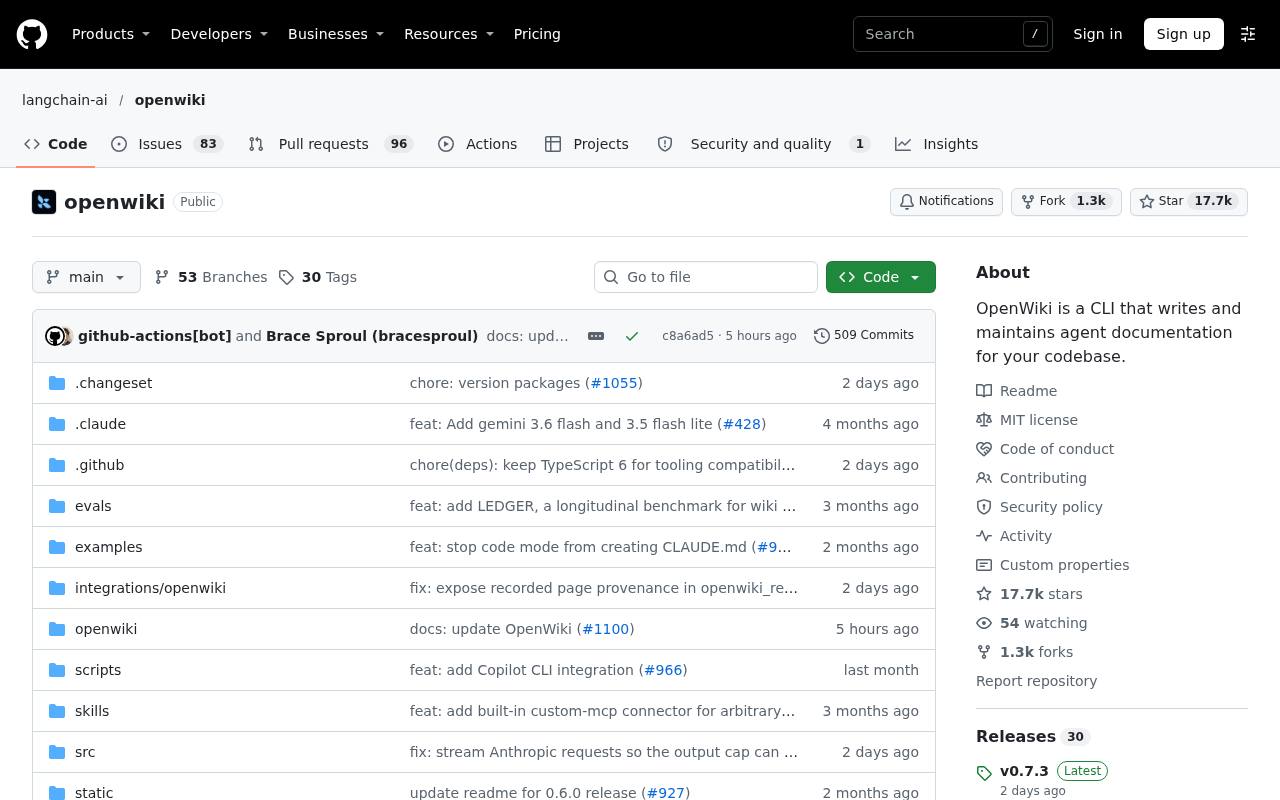
Deux de nos tests montrent ce modèle en pratique. claude-obsidian (3.8) construit un wiki Obsidian sourcé sur l'idée de Karpathy, avec des écritures planifiées et journalisées qui le rendent fiable et lent à adopter. OpenWiki (4.2) applique la même logique à une base de code et repère lesquelles de ses propres phrases sont devenues obsolètes quand le code change. Pour une carte ponctuelle d'un dépôt inconnu, Understand Anything (3.5) construit plutôt un graphe de connaissances, avec un coût en tokens élevé au premier passage.
Des hooks qui remplissent le wiki à votre place
L'étape suivante consiste à ne plus trier à la main. claude-memory-compiler adapte le modèle de Karpathy pour que la matière première soit vos propres sessions Claude Code. Un hook SessionEnd capture la transcription à la fermeture d'une session, un hook PreCompact la capture de nouveau avant que la compaction automatique ne résume le milieu, et un script en arrière-plan demande au modèle d'en extraire décisions, leçons et pièges dans un journal quotidien. Une étape de compilation transforme ces journaux en articles de concepts reliés entre eux, et un hook SessionStart place l'index dans votre session suivante. Un script de lint effectue sept vérifications.
C'est une boucle astucieuse, et elle comporte de vrais risques sur lesquels le README ne s'attarde pas.
- Les hooks exécutent du code shell. Un hook est une commande que Claude Code exécute avec son propre environnement, c'est-à-dire avec les accès de votre compte utilisateur. Copier le .claude/settings.json de quelqu'un d'autre dans votre projet, comme le demande l'installation, revient à exécuter ses scripts à chaque début et fin de session. Lisez-les d'abord.
- Les transcriptions contiennent des secrets. Une transcription de session contient tout ce qui y est passé : des clés collées, le contenu d'un fichier .env que Claude a lu, des données clients tirées d'un log. Le compilateur envoie ce texte au modèle et écrit les extraits dans des fichiers Markdown, et à notre lecture de son README et de son AGENTS.md, il n'y a aucune étape de masquage.
- L'étape de compilation écrit sans demander. Son AGENTS.md montre compile.py lancé avec permission_mode à acceptEdits, ce qui approuve automatiquement toute opération sur les fichiers de son dossier.
- L'affirmation sur la facturation contredit la documentation d'Anthropic. Le README affirme qu'Anthropic "has clarified that personal use of the Claude Agent SDK is covered under your existing Claude subscription", et AGENTS.md indique qu'aucune clé d'API n'est nécessaire puisqu'il utilise les identifiants enregistrés de Claude Code. Il ne cite aucune source. La présentation et le guide de démarrage de l'Agent SDK d'Anthropic demandent de définir une clé d'API, et précisent que, sauf accord préalable, les développeurs tiers ne peuvent pas proposer la connexion claude.ai ni ses limites d'usage dans des agents construits avec le SDK. Considérez l'affirmation sur l'abonnement comme non confirmée et prévoyez un budget API ; le propre tableau du projet chiffre la compilation d'un journal quotidien entre $0.45 et $0.65.
Le dépôt est par ailleurs jeune et calme : créé le 6 avril 2026, deux commits, environ 1 300 étoiles et aucun fichier de licence, ce qui signifie que vous n'avez aucun droit déclaré de réutiliser le code.
Il n'y a pas de taille magique pour le RAG
Chaque source ici donne un seuil, et elles ne s'accordent pas. Karpathy dit que la lecture de l'index fonctionne bien jusqu'à environ 100 sources et quelques centaines de pages, puis conseille un vrai outil de recherche. Les notes du compilateur disent que la lecture de l'index bat la recherche vectorielle entre 50 et 500 articles et que la recherche hybride devient nécessaire vers 2 000 articles ou 2 millions de tokens. Aucune ne fournit de mesure.
Le chiffre utile est le vôtre. Gardez une liste de vingt questions dont vous connaissez les réponses, posez-les toutes les quelques semaines et notez quelles pages le modèle a ouvertes et s'il a cité la bonne source. Quand les réponses commencent à manquer des pages qui existent, ou que l'index ne tient plus confortablement dans une session, ajoutez une recherche. Une mémoire hébergée comme Supermemory (4.0) ou un graphe local comme le serveur de référence Memory (3.5) sont des outils différents pour ce moment-là ; MemoryBase (3.2) résout un autre problème : transporter le contexte des conversations entre ChatGPT et Claude.
Quelle couche fait quel travail
| Couche | Qui l'écrit | À quoi elle sert | Peut-elle arrêter une action |
|---|---|---|---|
| CLAUDE.md | Vous | Instructions de travail et règles maison | Non, c'est du contexte |
| Auto Memory | Claude | Préférences et corrections apprises | Non, c'est du contexte |
| Hook PreToolUse | Vous | Règles qui doivent tenir | Oui |
| LLM Wiki | Claude, à partir de vos sources | Connaissances triées avec leur provenance | Non |
| Hooks de capture des transcriptions | Des scripts, automatiquement | Remplir le wiki à partir de vos sessions | Non, et ils exécutent du code |
Un déploiement par étapes
- Commencez par CLAUDE.md. Écrivez les instructions que vous répétez le plus, gardez le fichier sous 200 lignes et déplacez les règles propres à certains fichiers dans .claude/rules/.
- Laissez tourner Auto Memory, et lisez-la. Ouvrez /memory toutes les une ou deux semaines et supprimez ce qui est faux ou périmé.
- Passez les règles strictes dans des hooks. Tout ce que vous seriez contrarié de voir enfreint devient un hook PreToolUse ou un refus de permission, pas une phrase.
- Lancez un wiki à la main. Créez raw/, wiki/, index.md et log.md, mettez les règles dans CLAUDE.md, ingérez une source à la fois et planifiez un passage de lint.
- Mesurez avant d'ajouter une recherche. Gardez vos questions de test et n'ajoutez de récupération que lorsqu'elles commencent à échouer.
- Automatisez la capture en dernier, si vous le faites. Lisez chaque script de hook, gardez le wiki hors des dossiers partagés, vérifiez ce qui atterrit dans les journaux et utilisez une clé d'API avec un plafond de dépenses.
Le hic : un wiki entretenu par un modèle ne vaut que ce que valent ses passages de lint et votre lecture de ceux-ci. Le lint peut signaler une contradiction mais pas dire quel côté a raison, et un résumé assuré d'une source mal lue ressemble trait pour trait à un résumé juste. Garder raw/ inchangé est ce qui permet de vérifier, et cela ne sert que si quelqu'un vérifie.
Notre avis : voyez CLAUDE.md comme le mot sur le frigo, Auto Memory comme les habitudes que prend un colocataire, un hook comme le verrou de la porte et le wiki comme le classeur avec les justificatifs. La plupart des gens ont besoin des trois premiers cette semaine, et du classeur seulement quand les justificatifs s'accumulent. Le robot qui range tout à votre place peut attendre que vous ayez lu son code.