
Ollama ou LM Studio : lequel pour faire tourner vos modèles en local ?
Par ReviewRamble editors ·
Ollama et LM Studio font le même travail de base. Chacun télécharge un modèle ouvert, le fait tourner sur votre propre matériel et garde vos prompts sur votre machine. Aucun ne fait payer l'usage local. Le choix ne porte donc ni sur le prix ni sur la confidentialité ; il dépend de votre façon de travailler et de ce qui doit encore dialoguer avec le modèle.
La réponse courte
- Vous vivez dans un terminal, ou une autre app a besoin d'un modèle local derrière elle : Ollama (4.6). Une commande télécharge et lance un modèle, et la plupart des éditeurs, apps de chat et outils d'agents le proposent déjà comme backend.
- Vous voulez chercher, comparer et charger des modèles à la souris, ou l'installer pour un collègue qui n'a jamais ouvert de terminal : LM Studio (4.4).
- Il vous faut de l'open source de bout en bout : Ollama. L'app de bureau de LM Studio est propriétaire ; seuls sa CLI et ses SDK sont sous licence MIT.
- Vous êtes sur un Mac Apple Silicon : LM Studio fait aussi tourner les modèles MLX, bâtis sur le framework d'Apple pour ses puces, en plus du GGUF.
Ce qui les distingue
| Ollama | LM Studio | |
|---|---|---|
| Ce que c'est | Outil en ligne de commande avec serveur en arrière-plan | App de bureau avec serveur intégré |
| Licence | Open source (MIT) | Gratuit à la maison et au travail ; app propriétaire, CLI et SDK MIT |
| Formats de modèles | GGUF depuis sa propre bibliothèque | GGUF sur toutes les plateformes, plus MLX sur Apple Silicon |
| Trouver des modèles | ollama run plus un nom tiré d'une bibliothèque choisie | Recherche Hugging Face dans l'app |
| API locale | Port 11434, REST plus un point d'accès compatible OpenAI | Points d'accès compatibles OpenAI et Anthropic plus sa propre API REST |
| Contexte par défaut | 4 096 tokens sauf si vous l'augmentez | Réglé par modèle au chargement |
| Requêtes en parallèle | 1 par modèle par défaut | 4 emplacements par défaut depuis la 0.4.0 |
| Mot de passe sur l'API | Aucun | Désactivé par défaut ; jetons d'API disponibles depuis la 0.4.0 |
| Serveurs sans écran | Image Docker et script d'installation | llmster, le même moteur sans fenêtre |
| Options payantes | Ollama Cloud, dès 20 $ par mois | App d'agents Bionic, dès 20 $ par mois |
Ollama : la tuyauterie par défaut
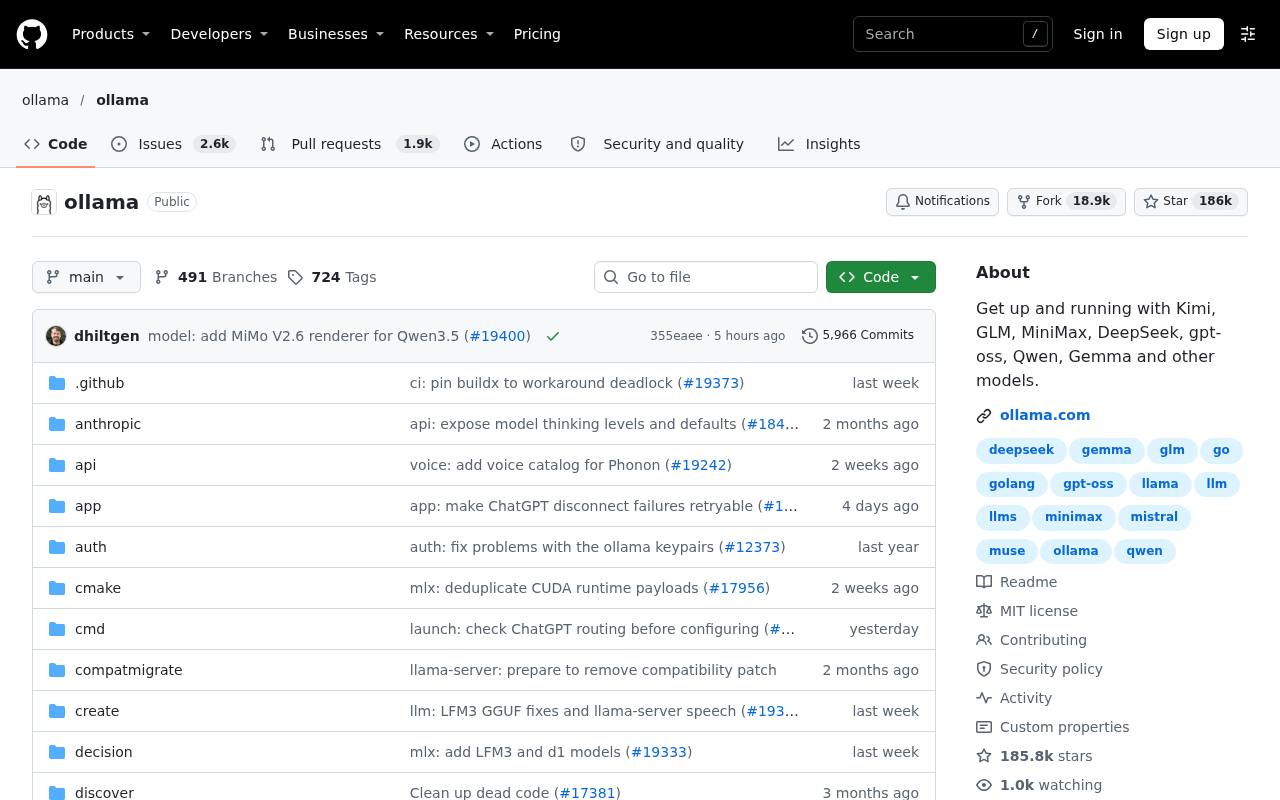
La force d'Ollama, c'est que les autres logiciels supposent qu'il est là. Avec environ 187 000 étoiles sur GitHub et des versions presque chaque semaine (la v0.40.16 est sortie le 9 novembre 2026), il est devenu l'API locale vers laquelle se tournent d'abord les agents de code et les apps de chat. ollama launch branche un modèle local sur Claude Code, Codex, Copilot CLI ou OpenCode en une étape.
Ses réglages par défaut visent une personne sur un portable. La FAQ fixe la fenêtre de contexte à 4 096 tokens, trop courte pour un agent de code qui lit plusieurs fichiers ; augmentez donc OLLAMA_CONTEXT_LENGTH avant d'accuser le modèle. Chaque modèle ne traite en outre qu'une requête à la fois tant que vous ne modifiez pas OLLAMA_NUM_PARALLEL.
LM Studio : la vitrine accueillante
LM Studio est celui qu'on confie à quelqu'un qui veut une IA privée sans apprendre de commandes. Vous cherchez un modèle, le téléchargez et discutez, avec des documents joints si vous le souhaitez. Sa politique de confidentialité indique que les conversations locales ne quittent jamais la machine et que l'app ne contient aucune télémétrie.
C'est aussi un serveur compétent. Activez-le et il répond aux requêtes au format d'OpenAI et d'Anthropic, si bien que Claude Code peut s'y connecter en changeant une seule URL de base. Depuis la version 0.4.0, il traite 4 requêtes en parallèle par défaut, ce qui rend une machine partagée en équipe plus pratique que la configuration d'origine d'Ollama.
Le point de sécurité qu'ils partagent
Les deux serveurs n'écoutent par défaut que sur votre propre ordinateur, et aucun ne demande de mot de passe sauf si vous en configurez un. Les ennuis commencent quand vous les ouvrez au réseau. Ollama n'a aucune connexion intégrée, et en janvier 2026 des chercheurs ont compté 175 000 serveurs Ollama joignables depuis internet. Le mode réseau de LM Studio ouvre son serveur à tous les appareils de votre réseau, et sa propre documentation demande d'activer d'abord les jetons d'API. Si l'un des deux doit être joignable depuis une autre machine, placez-le derrière une authentification ou gardez-le sur un réseau privé comme Tailscale.
Coût
Faire tourner des modèles en local ne coûte rien d'autre que le matériel, avec l'un comme avec l'autre. LM Studio recommande 16GB de mémoire et ne prend pas en charge les Mac Intel. Les deux entreprises vendent désormais quelque chose en plus : Ollama Cloud fait tourner de plus gros modèles pour vous, dès 20 $ par mois avec 60 $ de crédits, et l'app séparée Bionic de LM Studio ajoute des agents et des modèles hébergés à 20 $ ou 100 $ par mois. Vous n'avez besoin ni de l'un ni de l'autre pour faire tourner des modèles sur votre propre machine.
Notre avis : voyez Ollama comme le moteur et LM Studio comme le tableau de bord. Les développeurs qui écrivent des scripts, lancent des agents ou construisent des apps sur un modèle local seront plus à l'aise avec Ollama. Ceux qui veulent essayer des modèles, les comparer côte à côte et tout garder dans une fenêtre iront plus vite avec LM Studio. Beaucoup installent les deux.