
Gemini 4 Carbon führt die Rangliste an. Nutzen kannst du es noch nicht
Von Andrew Miller ·
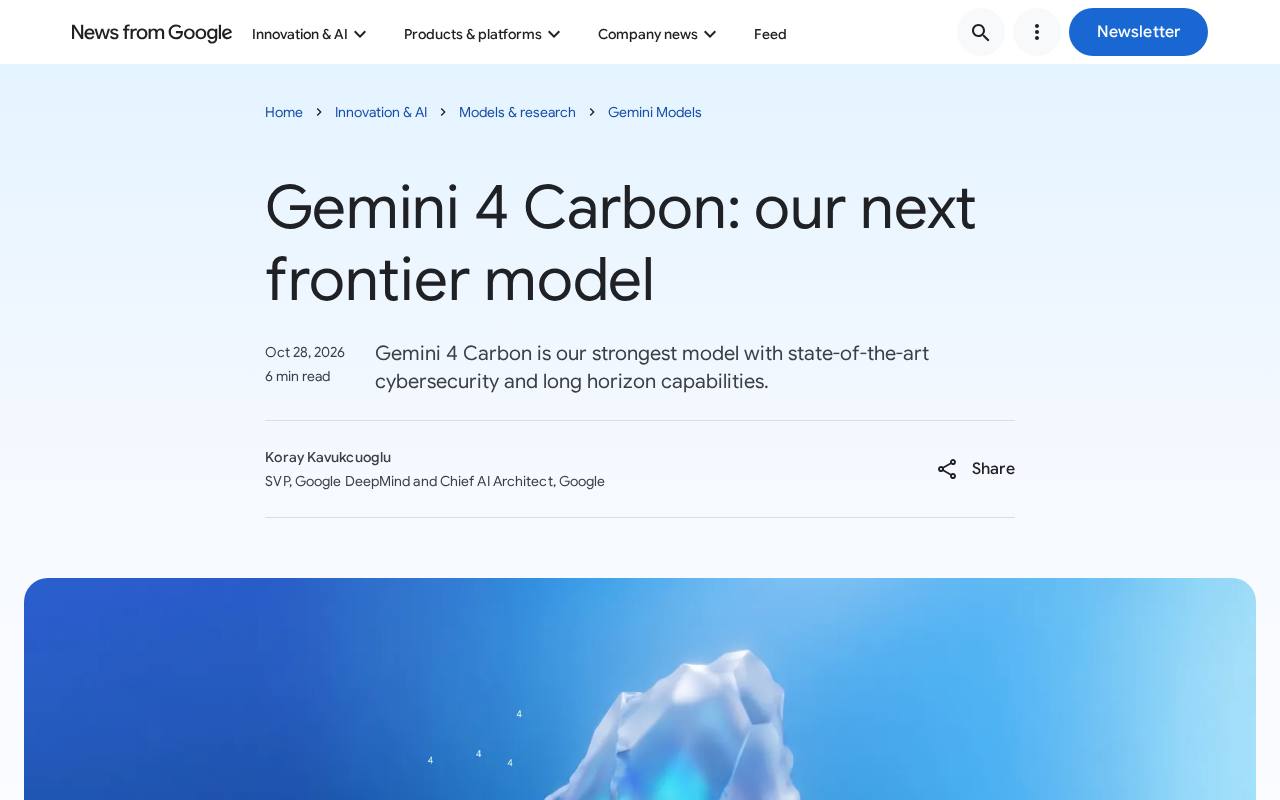
Du musst diesen Monat ein Projekt ausliefern und dafür ein Modell wählen. Das Modell an der Spitze der Rangliste ist diese Woche eines, das du mit ziemlicher Sicherheit nicht nutzen kannst. Gemini 4 Carbon, das Google am 28. Oktober angekündigt hat, steht nur einer kleinen Gruppe geprüfter Sicherheitsteams offen, ohne Termin für alle anderen. Hier steht, was es an einer Entscheidung ändert, die du heute treffen musst, und was nicht.
Was Google veröffentlicht hat, und für wen
Carbon ist das neue Spitzenmodell von Google DeepMind und kommt zwei Wochen, nachdem Gemini 4 Argon zahlende Abonnenten erreicht hat. Google hat eine allgemeine Veröffentlichung wegen seiner Sicherheitsfähigkeiten zurückgehalten. Ein Modell, das gut darin ist, Lücken in Software zu finden und zu schließen, ist auch gut darin, einzubrechen.
Vorerst geht es daher an einen Teil der Cyberverteidiger in Fairwind, Googles Programm nur auf Einladung, und an Googles eigene Teams. Laut NeuralTrust laufen Bewerbungen über ein Account-Team von Google Cloud, mit Hintergrundprüfungen. Allen anderen wurde es „so bald wie möglich“ versprochen.
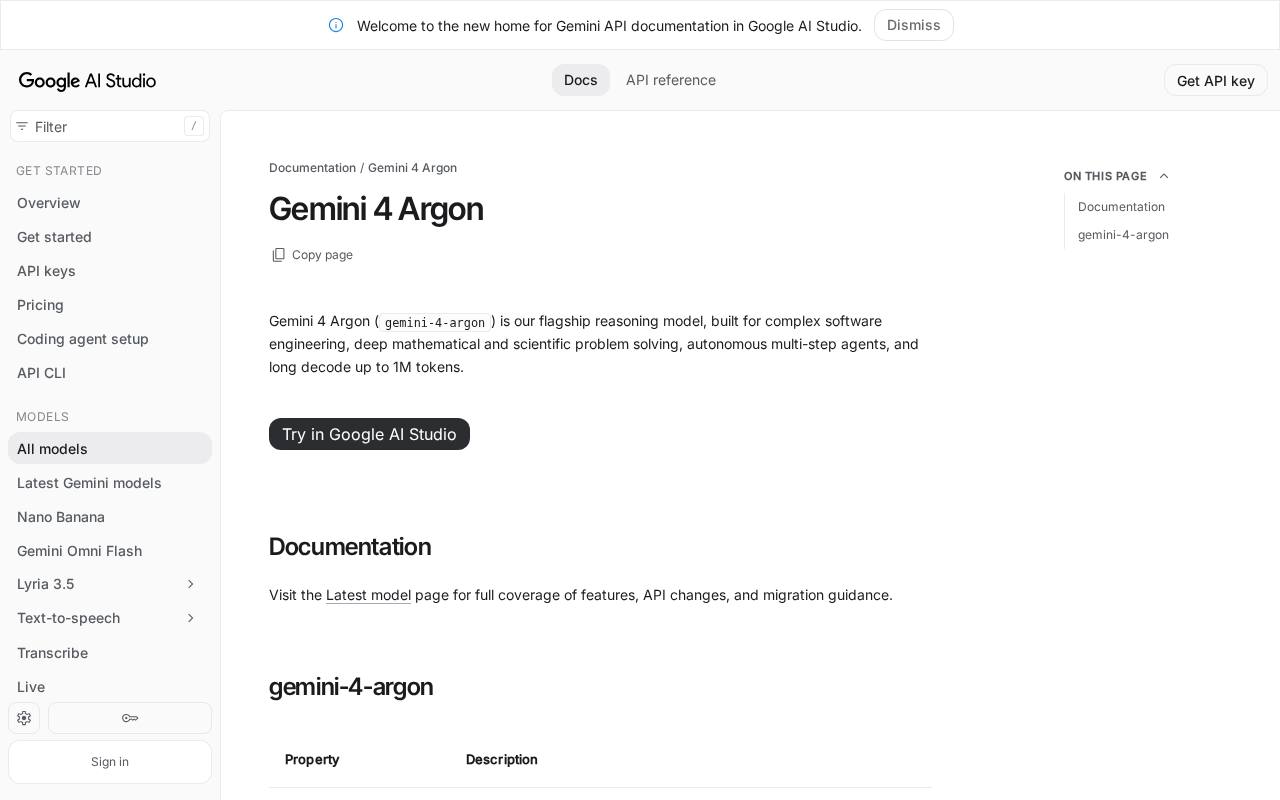
Es gibt keine öffentliche Modell-ID, keine Model Card und keine von Google veröffentlichten Limits. Am 1. November führen die Modell- und Preisseiten der Gemini API aus der Familie Gemini 4 nur Argon auf.
Spitze der Rangliste, mit einem einzigen Punkt
Im Artificial Analysis Intelligence Index, einer unabhängigen Wertung aus vielen Tests, erreicht Carbon 59. Claude Opus 5.5 erreicht auf der höchsten Effort-Stufe 58, GPT-6 Astra 57 und Argon 50. Claude Fable 5.1, Anthropics teuerstes Modell, kommt höchstens auf 50, Claude Sonnet 5.5 auf 54.
Ein Punkt ist ein dünner Vorsprung. Der zweite unabhängige Tester, Vals, setzt Carbon in seinem eigenen Index mit 70,36% auf Platz zwei, hinter Sonnet 5.5 mit 70,85% und knapp vor Opus 5.5 mit 70,18%, alle innerhalb seiner Fehlermarge von etwa einem Punkt. Bei Vals führt Carbon zwei Fachranglisten klar an: Finanzen (66,35%) und juristische Recherche (55,77%).
Die faire Zusammenfassung ist ein Dreifach-Gleichstand an der Spitze, mit Carbon auf einer Anzeigetafel eine Nasenlänge vorn.
Coding und Agenten: nicht der Spitzenreiter
Googles Launch-Tabelle, die auf eigenen Angaben beruht und keine Fehlermargen nennt, beansprucht in 15 von 17 Zeilen den besten Wert. Die beiden, die sie abgibt, sind die, die Entwicklern am wichtigsten sind. Bei FrontierSWE 2, einem Test echter Softwareentwicklung, erreicht Carbon 61,2% gegenüber 65,5% bei Astra und 62,3% bei Opus. Bei OSWorld, wo das Modell selbstständig einen Computer bedient, erreicht es 81,5% gegenüber 87,2% bei Opus.
Die eigenen Angaben der Konkurrenten weisen in dieselbe Richtung. Anthropic gibt für Opus 5.5 auf Terminal-Bench 4.0, einem Test für Agenten in der Kommandozeile, 66,4% an, gegenüber 57,9% für Astra und 55,8% für Fable 5.1. Google gab für Argon im selben Test 57,4% an.
Carbons deutlichster Vorsprung in Googles Tabelle liegt beim Lesen sehr langer Eingaben: 96,2% bei GraphWalks, gegenüber 71,8% für Astra und 66,8% für Opus. Wenn deine Arbeit bedeutet, einer ganzen Codebasis oder einem Datenraum auf einmal Fragen zu stellen, ist das die Zahl, auf die du achten solltest.
Weniger erfundene Antworten, aber mehr als bei Argon
Bei Halluzinationen, also wenn ein Modell selbstsicher etwas Falsches behauptet, ist Carbons Vorsprung am größten. Im Omniscience-Test von Artificial Analysis erfindet es laut VentureBeat in 11% der Fälle etwas, gegenüber 50% bei Opus 5.5 und bei Astra.
Das widerspricht einem Teil von Googles eigener Darstellung. Google sagt, Carbon mache etwa halb so viele unbelegte Behauptungen wie Argon, doch im selben Test lag Argons Quote bei 4%. Carbon beantwortet mehr Fragen richtig, 58% gegenüber 48%, rät aber öfter, wenn es etwas nicht weiß.
Preis, und die Rechnung pro Aufgabe
Google hat Carbon zu denselben Sätzen wie Argon angekündigt: anfangs 2 $ pro Million Input-Tokens und 10 $ pro Million Output-Tokens, danach 4 $ und 20 $. Argons Einführungspreis endet am 30. November; wann der von Carbon endet, hat Google nicht gesagt.
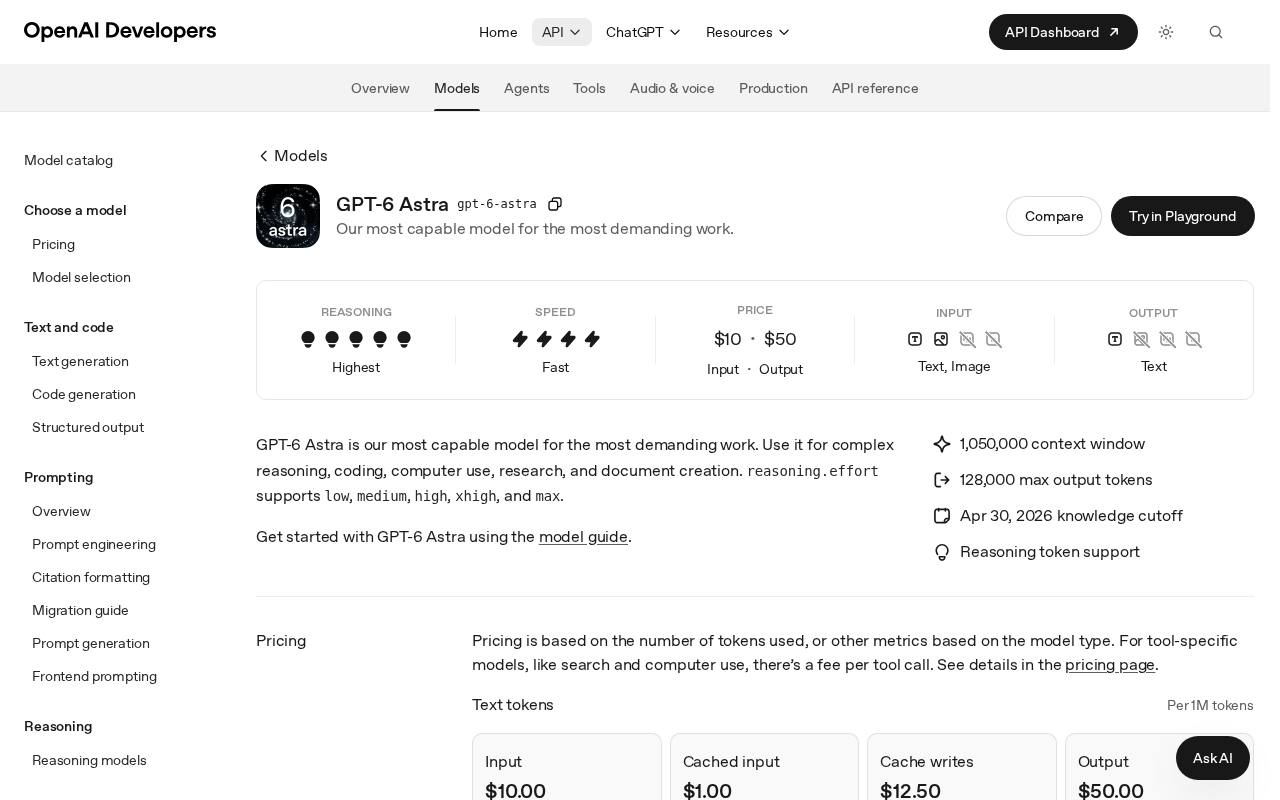
Bei 4 $/20 $ liegen beide Gemini-Modelle pro Token gleichauf mit Opus 5.5. Fable 5.1 und Astra kosten 10 $ und 50 $, also das Zweieinhalbfache.
Preise pro Token führen in die Irre, weil Modelle unterschiedlich viel schreiben. Carbon brauchte 200 Millionen Output-Tokens, um den Index von Artificial Analysis zu durchlaufen, gegenüber einem Median von 70 Millionen. Zum späteren Satz ergibt das 7,76 $ pro Index-Aufgabe, gegenüber 7,68 $ für Argon, 10,04 $ für Opus 5.5 und 6,25 $ für Astra. Carbon ist pro Aufgabe günstiger als Opus, aber nicht so deutlich, wie die Token-Zahl allein vermuten lässt.
Tempo: zwei Minuten Wartezeit
Artificial Analysis misst 118,58 Sekunden, bis Carbons erstes Wort erscheint, gegenüber einem Median von 3,71 Sekunden. Argon braucht 49,13 Sekunden.
Auch die Konkurrenten sind auf ihren höchsten Stufen langsam, und von dort stammen ihre Spitzenwerte. In derselben Rangliste wartet Opus 5.5 auf maximalem Effort 729,62 Sekunden und Astra auf Maximum 270,03. Auf mittlerem Effort sinkt das auf 16,41 und 5,07 Sekunden, mit niedrigeren Werten. Jedes dieser Modelle passt mit voller Leistung zu einer Aufgabe, die du abgibst und später abholst, nicht zu einem Chatfenster.
Der Haken: Jede Carbon-Zahl oben stammt von Testern mit frühem Zugang und aus Googles eigener Tabelle. Niemand außerhalb von Fairwind kann sie an der eigenen Arbeit prüfen, Google hat nicht gesagt, ob das endgültige öffentliche Modell dem getesteten entspricht, und seine Bedingungen zu Datenaufbewahrung und Training sind nicht veröffentlicht. Ein Ranglistensieg für ein Modell, das du nicht aufrufen kannst, ist eine Prognose, kein Produkt.
Welches Modell für welche Aufgabe
- Lange Coding- und Agent-Aufgaben: Claude Opus 5.5. Es führt bei Terminal-Bench 4.0 und OSWorld, liegt im Index einen Punkt hinter Carbon und ist heute über fünf Plattformen erhältlich.
- Die meiste Produktionsarbeit mit kleinem Budget: Claude Sonnet 5.5 oder GPT-6.1 Sol, beide 2 $/10 $. Sonnet führt den Index von Vals an; Sol erreicht bei Artificial Analysis auf maximalem Effort 55.
- Video, Audio und Stapel von PDFs: Gemini 4 Argon, das all das nativ in einem Fenster von 1M Tokens liest. Plane die Preisverdopplung am 1. Dezember ein.
- Mathematik und Naturwissenschaft auf Forschungsniveau: GPT-6 Astra, für das OpenAI 64,6% auf Terminal-Bench Science angibt, gegenüber 52,6% für Fable 5.1.
- Das schwierigste Schlussfolgern, nachdem Opus nicht gereicht hat: Claude Fable 5.1. Anthropics eigene Dokumentation rät inzwischen, mit Opus anzufangen.
- Geprüfte Sicherheitsteams: Gemini 4 Carbon über Fairwind oder GPT-5.6-Cyber über OpenAIs Programm Daybreak Red.
- Niedrigere Preise: Kimi K3.1 Pro für 2 $/10 $, mit offenen Gewichten, die bis zum 4. November versprochen sind.
Unser Fazit: Carbon zählt vor allem als Signal, wohin Argons Nachfolger in der Gemini API steuert, und als Grund für Gemini-Teams, ihre Budgets stabil zu halten. Für alle anderen ist die Entscheidung dieselbe wie letzte Woche. Opus 5.5 ist das Frontier-Modell, das du tatsächlich kaufen kannst, einen Punkt hinter dem Spitzenreiter, und ein späterer Wechsel kostet weniger als das Warten auf einen Termin, den Google nicht festgelegt hat.