
O Gemini 4 Carbon lidera o ranking. Você ainda não pode usá-lo
Por Andrew Miller ·
Você tem um projeto para entregar este mês e um modelo para escolher. O modelo no topo do ranking nesta semana é um que você quase certamente não pode usar. O Gemini 4 Carbon, que o Google anunciou em 28 de outubro, está aberto só a um pequeno grupo de equipes de segurança aprovadas, sem data para mais ninguém. Eis o que ele muda, e o que não muda, em uma escolha que você precisa fazer hoje.
O que o Google lançou, e para quem
O Carbon é o novo modelo de topo do Google DeepMind, chegando duas semanas depois de o Gemini 4 Argon chegar aos assinantes pagantes. O Google segurou um lançamento geral por causa das habilidades de segurança do modelo. Um modelo bom em encontrar e corrigir falhas em software também é bom em invadir.
Então, por enquanto, ele vai para um subconjunto de defensores cibernéticos no Fairwind, o programa do Google só para convidados, e para as equipes do próprio Google. Segundo a NeuralTrust, os pedidos passam por uma equipe de conta do Google Cloud, com checagem de antecedentes. A todos os outros foi prometido acesso "o mais rápido possível".
Não há ID de modelo público, nem model card, nem limites publicados pelo Google. Em 1º de novembro, as páginas de modelos e preços da Gemini API listam só o Argon da família Gemini 4.
No topo do ranking, por um único ponto
No Artificial Analysis Intelligence Index, uma pontuação independente construída a partir de muitos testes, o Carbon marca 59. O Claude Opus 5.5 marca 58 na configuração de esforço máximo, o GPT-6 Astra 57 e o Argon 50. O Claude Fable 5.1, o modelo mais caro da Anthropic, chega no máximo a 50, e o Claude Sonnet 5.5 a 54.
Um ponto é uma liderança estreita. O segundo avaliador independente, a Vals, coloca o Carbon em segundo no seu próprio índice, com 70,36%, atrás do Sonnet 5.5, com 70,85%, e logo à frente do Opus 5.5, com 70,18%, todos dentro da margem de erro de cerca de um ponto. O Carbon lidera isoladamente dois rankings especializados na Vals: finanças (66,35%) e pesquisa jurídica (55,77%).
O resumo justo é um empate triplo no topo, com o Carbon um nariz à frente em um dos placares.
Programação e agentes: não é o líder
A tabela de lançamento do Google, que é autorrelatada e não traz margens de erro, reivindica a maior pontuação em 15 de 17 linhas. As duas que ele cede são as que mais importam para desenvolvedores. No FrontierSWE 2, um teste de engenharia de software real, o Carbon marca 61,2% contra 65,5% do Astra e 62,3% do Opus. No OSWorld, em que o modelo opera um computador sozinho, marca 81,5% contra 87,2% do Opus.
Os números autorrelatados dos rivais apontam na mesma direção. A Anthropic coloca o Opus 5.5 em 66,4% no Terminal-Bench 4.0, um teste de agentes trabalhando em linha de comando, contra 57,9% do Astra e 55,8% do Fable 5.1. O Google colocou o Argon em 57,4% no mesmo teste.
A liderança mais clara do Carbon na tabela do Google está na leitura de entradas muito longas: 96,2% no GraphWalks, contra 71,8% do Astra e 66,8% do Opus. Se o seu trabalho envolve fazer perguntas a uma base de código inteira ou a uma data room de uma vez, esse é o número a acompanhar.
Menos respostas inventadas, mas mais que o Argon
Alucinação, um modelo afirmar algo falso com confiança, é onde a liderança do Carbon é maior. No teste Omniscience da Artificial Analysis, ele inventa coisas em 11% das vezes, segundo a VentureBeat, contra 50% tanto do Opus 5.5 quanto do Astra.
Isso contradiz parte da própria narrativa do Google. O Google diz que o Carbon faz cerca de metade das afirmações sem respaldo do Argon, mas no mesmo teste a taxa do Argon foi de 4%. O Carbon responde corretamente a mais perguntas, 58% contra 48%, mas chuta com mais frequência quando não sabe.
Preço, e a conta por tarefa
O Google anunciou o Carbon com os mesmos preços do Argon: um valor promocional de US$ 2 por milhão de tokens de entrada e US$ 10 por milhão de saída, depois US$ 4 e US$ 20. O preço promocional do Argon termina em 30 de novembro; o Google não disse quando terminaria o do Carbon.
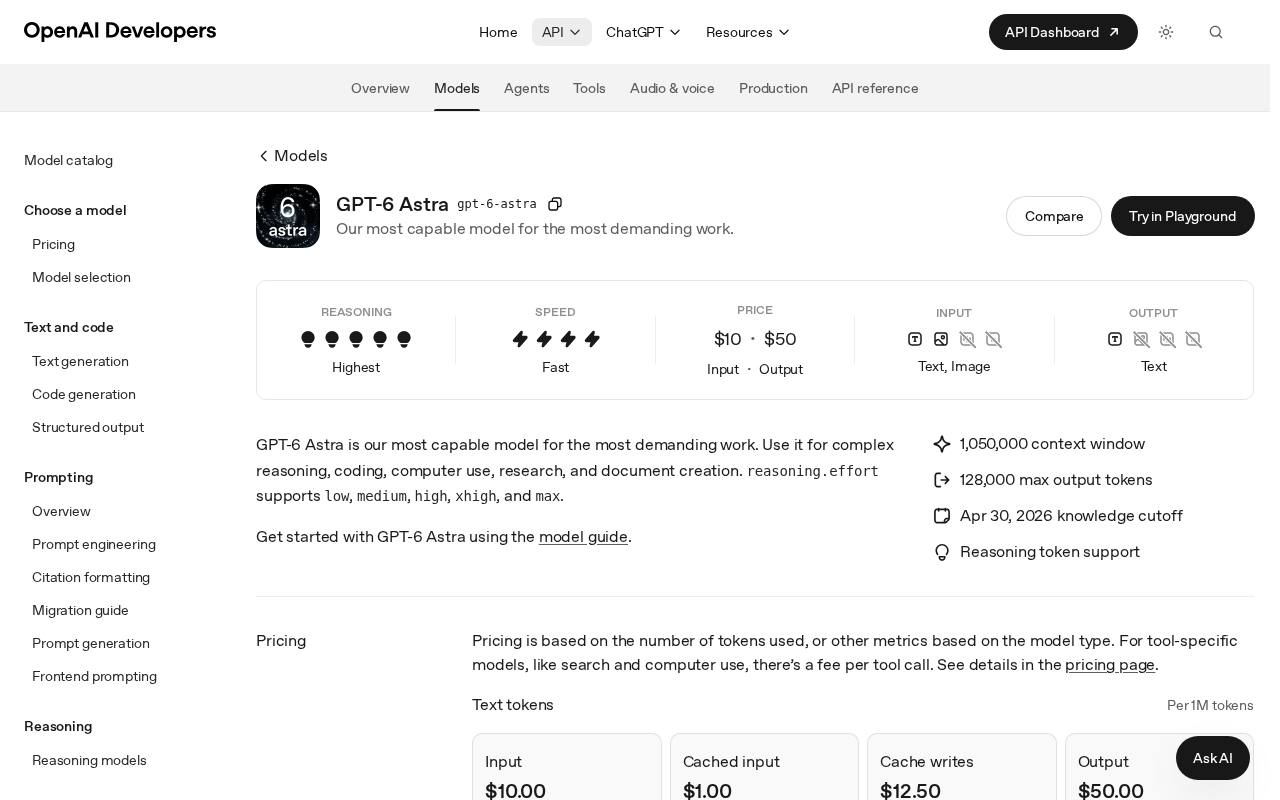
A US$ 4/US$ 20, os dois modelos Gemini empatam por token com o Opus 5.5. O Fable 5.1 e o Astra custam US$ 10 e US$ 50, duas vezes e meia mais.
Preços por token enganam, porque os modelos diferem em quanto escrevem. O Carbon usou 200 milhões de tokens de saída para rodar o índice da Artificial Analysis, contra uma mediana de 70 milhões. No preço posterior, isso dá US$ 7,76 por tarefa do índice, contra US$ 7,68 do Argon, US$ 10,04 do Opus 5.5 e US$ 6,25 do Astra. O Carbon é mais barato por tarefa que o Opus, mas não tanto quanto a contagem de tokens sozinha sugere.
Velocidade: uma espera de dois minutos
A Artificial Analysis mede 118,58 segundos até a primeira palavra do Carbon aparecer, contra uma mediana de 3,71 segundos. O Argon leva 49,13 segundos.
Os rivais também são lentos nas configurações máximas, que é de onde vêm suas pontuações de destaque. No mesmo ranking, o Opus 5.5 em esforço máximo espera 729,62 segundos e o Astra no máximo 270,03. Em esforço médio, caem para 16,41 e 5,07 segundos, com pontuações menores. Qualquer um desses modelos em força total serve para uma tarefa que você entrega e volta depois, não para uma janela de chat.
O porém: todos os números do Carbon acima vêm de avaliadores com acesso antecipado e da tabela do próprio Google. Ninguém fora do Fairwind pode conferi-los no próprio trabalho, o Google não disse se o modelo público final vai corresponder ao que foi testado, e seus termos de retenção e treinamento não estão publicados. Uma vitória no ranking de um modelo que você não pode chamar é uma previsão, não um produto.
Qual para cada tarefa
- Tarefas longas de programação e de agentes: Claude Opus 5.5. Lidera o Terminal-Bench 4.0 e o OSWorld, fica um ponto atrás do Carbon no índice e está à venda em cinco plataformas hoje.
- A maior parte do trabalho de produção com orçamento limitado: Claude Sonnet 5.5 ou GPT-6.1 Sol, ambos a US$ 2/US$ 10. O Sonnet lidera o índice da Vals; o Sol marca 55 na Artificial Analysis em esforço máximo.
- Vídeo, áudio e pilhas de PDFs: Gemini 4 Argon, que lê todos eles nativamente em uma janela de 1M de tokens. Planeje-se para o preço dobrar em 1º de dezembro.
- Matemática e ciência de nível de pesquisa: GPT-6 Astra, que a OpenAI informa ter 64,6% no Terminal-Bench Science, contra 52,6% do Fable 5.1.
- O raciocínio mais difícil, depois que o Opus não deu conta: Claude Fable 5.1. A própria documentação da Anthropic agora diz para começar pelo Opus.
- Equipes de segurança aprovadas: Gemini 4 Carbon pelo Fairwind, ou GPT-5.6-Cyber pelo programa Daybreak Red da OpenAI.
- Preços menores: Kimi K3.1 Pro a US$ 2/US$ 10, com pesos abertos prometidos até 4 de novembro.
Nossa opinião: o Carbon importa mais como sinal de para onde vai o sucessor do Argon na Gemini API, e como motivo para equipes que usam o Gemini manterem seus orçamentos estáveis. Para todos os outros, a decisão é a mesma da semana passada. O Opus 5.5 é o modelo de fronteira que você realmente pode comprar, um ponto atrás do líder, e trocar depois custa menos do que esperar por uma data que o Google não definiu.