
Gemini 4 Carbon encabeza la clasificación. Todavía no puedes usarlo
Por Andrew Miller ·
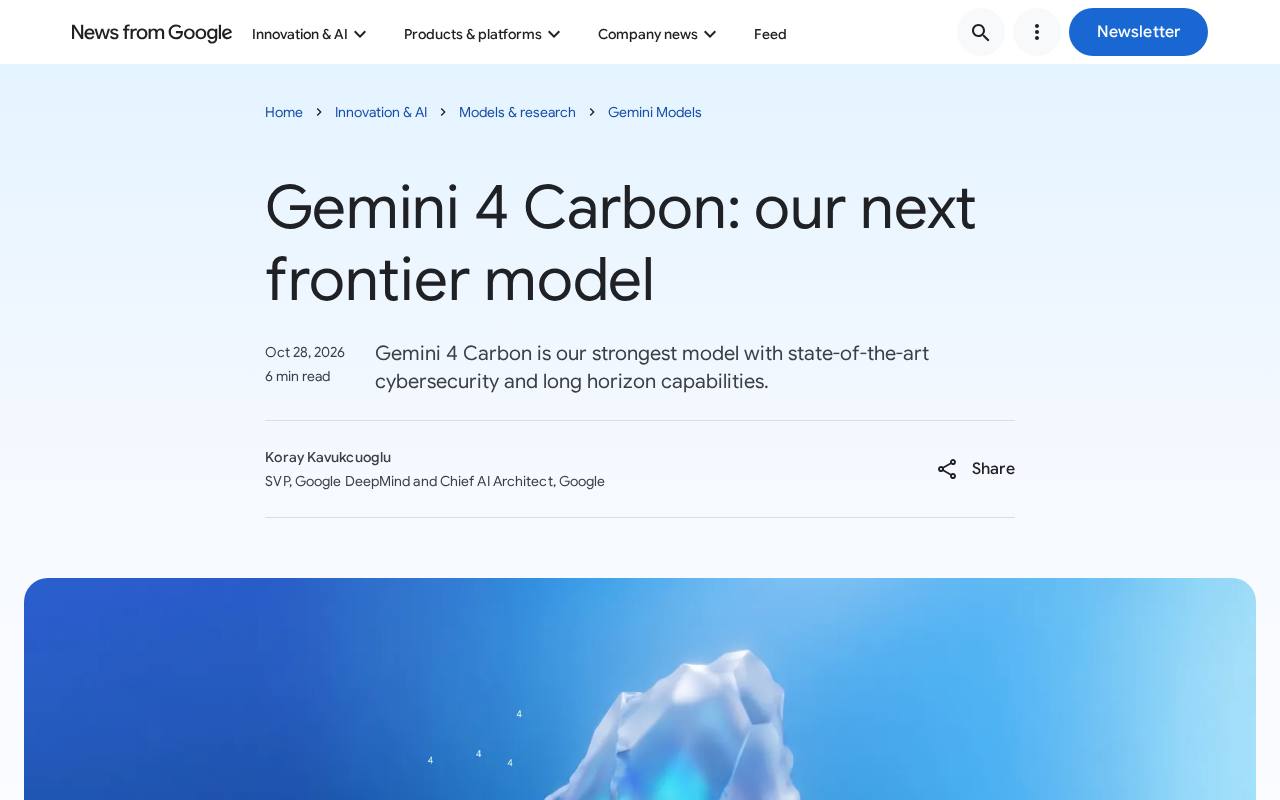
Tienes un proyecto que entregar este mes y un modelo que elegir para él. El modelo que encabeza la clasificación esta semana es uno que casi con toda seguridad no puedes usar. Gemini 4 Carbon, que Google anunció el 28 de octubre, solo está abierto a un pequeño grupo de equipos de seguridad verificados, sin fecha para nadie más. Esto es lo que cambia, y lo que no, para una elección que tienes que hacer hoy.
Qué ha lanzado Google y para quién
Carbon es el nuevo modelo principal de Google DeepMind, y llega dos semanas después de que Gemini 4 Argon llegara a los suscriptores de pago. Google ha retenido el lanzamiento general por sus capacidades de seguridad. Un modelo que es bueno encontrando y parcheando agujeros en el software también es bueno entrando por ellos.
Así que, por ahora, va a una parte de los defensores de ciberseguridad de Fairwind, el programa de Google solo por invitación, y a los propios equipos de Google. Según NeuralTrust, las solicitudes pasan por un equipo de cuentas de Google Cloud, con comprobación de antecedentes. A todos los demás se les ha prometido "as soon as possible" (lo antes posible).
No hay ID público del modelo, ni ficha del modelo, ni límites publicados por Google. A 1 de noviembre, las páginas de modelos y precios de la API de Gemini solo incluyen Argon de la familia Gemini 4.
Primero de la tabla, por un solo punto
En el Artificial Analysis Intelligence Index, una puntuación independiente construida a partir de muchas pruebas, Carbon obtiene 59. Claude Opus 5.5 obtiene 58 con su ajuste de esfuerzo máximo, GPT-6 Astra 57 y Argon 50. Claude Fable 5.1, el modelo más caro de Anthropic, llega como máximo a 50, y Claude Sonnet 5.5 a 54.
Un punto es una ventaja escasa. El segundo evaluador independiente, Vals, coloca a Carbon segundo en su propio índice con un 70,36%, por detrás de Sonnet 5.5 con un 70,85% y justo por delante de Opus 5.5 con un 70,18%, todos dentro de su margen de error de alrededor de un punto. Carbon sí lidera con claridad dos clasificaciones especializadas de Vals: finanzas (66,35%) e investigación jurídica (55,77%).
El resumen justo es un triple empate en cabeza, con Carbon por delante por un pelo en una de las tablas.
Programación y agentes: no es el líder
La tabla de lanzamiento de Google, con datos propios y sin márgenes de error, reivindica la mejor puntuación en 15 de 17 filas. Las dos que concede son las que más importan a los desarrolladores. En FrontierSWE 2, una prueba de ingeniería de software real, Carbon obtiene un 61,2% frente al 65,5% de Astra y el 62,3% de Opus. En OSWorld, donde el modelo maneja un ordenador por sí solo, obtiene un 81,5% frente al 87,2% de Opus.
Las cifras propias de los rivales apuntan en la misma dirección. Anthropic sitúa a Opus 5.5 en un 66,4% en Terminal-Bench 4.0, una prueba de agentes que trabajan en una línea de comandos, frente al 57,9% de Astra y el 55,8% de Fable 5.1. Google situó a Argon en un 57,4% en la misma prueba.
La ventaja más clara de Carbon en la tabla de Google está en la lectura de entradas muy largas: un 96,2% en GraphWalks, frente al 71,8% de Astra y el 66,8% de Opus. Si tu trabajo consiste en hacer preguntas sobre todo un código fuente o una sala de datos de una vez, esa es la cifra a vigilar.
Menos respuestas inventadas, pero más que Argon
La alucinación, que un modelo afirme con seguridad algo falso, es donde la ventaja de Carbon es mayor. En la prueba Omniscience de Artificial Analysis se inventa cosas el 11% de las veces, según VentureBeat, frente al 50% tanto de Opus 5.5 como de Astra.
Eso contradice parte del relato de la propia Google. Google dice que Carbon hace aproximadamente la mitad de afirmaciones sin respaldo que Argon, pero en la misma prueba la tasa de Argon fue del 4%. Carbon responde bien a más preguntas, un 58% frente a un 48%, pero adivina más a menudo cuando no sabe.
Precio, y la factura por tarea
Google ha anunciado Carbon con las mismas tarifas que Argon: un precio introductorio de 2 $ por millón de tokens de entrada y 10 $ por millón de salida, y después 4 $ y 20 $. La tarifa introductoria de Argon termina el 30 de noviembre; Google no ha dicho cuándo terminaría la de Carbon.
A 4 $/20 $, los dos modelos Gemini igualan a Opus 5.5 por token. Fable 5.1 y Astra cuestan 10 $ y 50 $, dos veces y media más.
Los precios por token engañan, porque los modelos difieren en cuánto escriben. Carbon usó 200 millones de tokens de salida para completar el índice de Artificial Analysis, frente a una mediana de 70 millones. Con la tarifa posterior, eso sale a 7,76 $ por tarea del índice, frente a 7,68 $ de Argon, 10,04 $ de Opus 5.5 y 6,25 $ de Astra. Carbon es más barato por tarea que Opus, pero no tanto como sugeriría el recuento de tokens por sí solo.
Velocidad: una espera de dos minutos
Artificial Analysis mide 118,58 segundos hasta que aparece la primera palabra de Carbon, frente a una mediana de 3,71 segundos. Argon tarda 49,13 segundos.
Los rivales también son lentos con sus ajustes máximos, que es de donde salen sus puntuaciones destacadas. En la misma clasificación, Opus 5.5 con esfuerzo máximo espera 729,62 segundos y Astra en máximo 270,03. Con esfuerzo medio bajan a 16,41 y 5,07 segundos, con puntuaciones más bajas. Cualquiera de estos modelos a plena potencia sirve para un trabajo que encargas y al que vuelves después, no para una ventana de chat.
La pega: todas las cifras de Carbon de arriba proceden de evaluadores con acceso anticipado y de la propia tabla de Google. Nadie fuera de Fairwind puede comprobarlas con su propio trabajo, Google no ha dicho si el modelo público final coincidirá con lo que se probó, y sus condiciones de conservación de datos y entrenamiento no están publicadas. Ganar una clasificación con un modelo al que no puedes llamar es una previsión, no un producto.
Cuál para cada trabajo
- Trabajos largos de programación y de agentes: Claude Opus 5.5. Lidera Terminal-Bench 4.0 y OSWorld, está a un punto de Carbon en el índice y hoy se vende a través de cinco plataformas.
- La mayor parte del trabajo en producción con poco presupuesto: Claude Sonnet 5.5 o GPT-6.1 Sol, ambos a 2 $/10 $. Sonnet encabeza el índice de Vals; Sol obtiene 55 en Artificial Analysis con esfuerzo máximo.
- Vídeo, audio y montones de PDF: Gemini 4 Argon, que los lee todos de forma nativa en una ventana de 1M de tokens. Cuenta con que el precio se duplica el 1 de diciembre.
- Matemáticas y ciencia de nivel investigador: GPT-6 Astra, al que OpenAI atribuye un 64,6% en Terminal-Bench Science, frente al 52,6% de Fable 5.1.
- El razonamiento más difícil, cuando Opus se ha quedado corto: Claude Fable 5.1. La propia documentación de Anthropic dice ahora que se empiece por Opus.
- Equipos de seguridad verificados: Gemini 4 Carbon a través de Fairwind, o GPT-5.6-Cyber a través del programa Daybreak Red de OpenAI.
- Precios más bajos: Kimi K3.1 Pro a 2 $/10 $, con pesos abiertos prometidos para el 4 de noviembre.
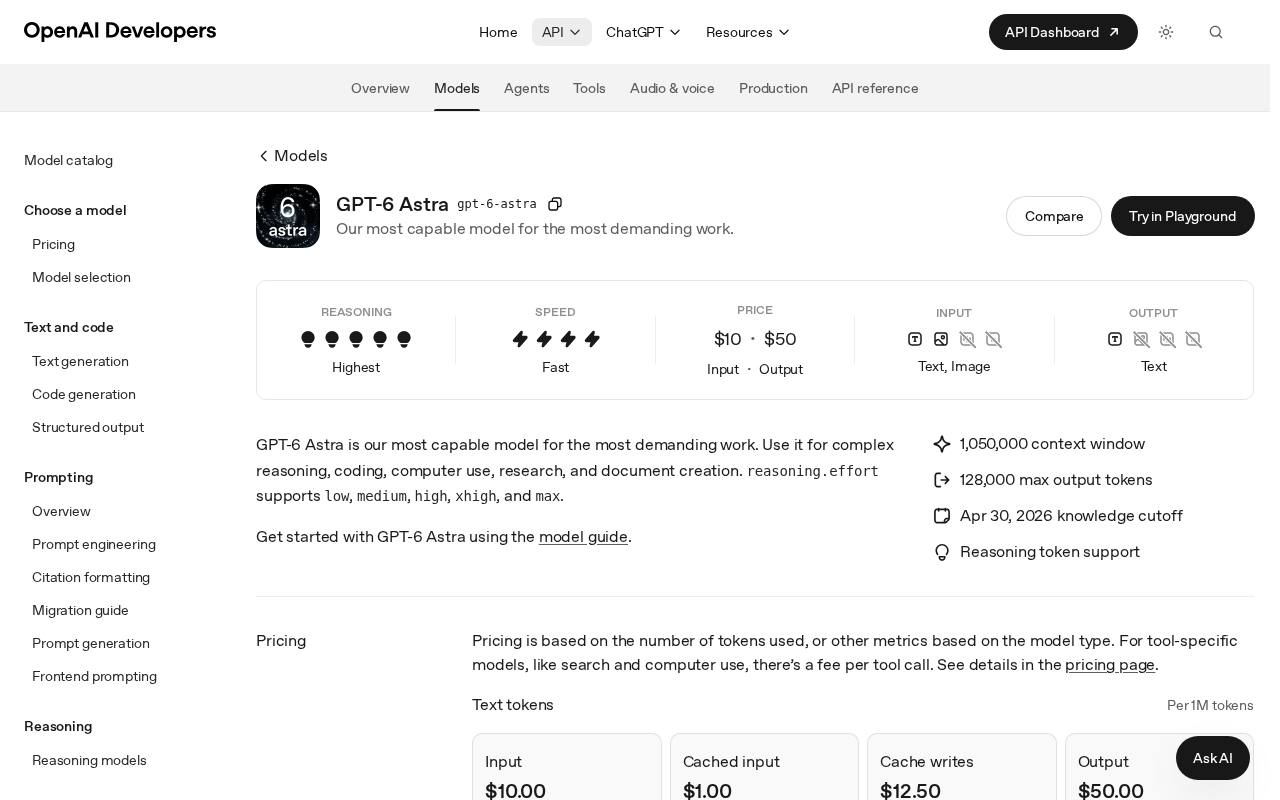
Nuestra opinión: Carbon importa sobre todo como señal de hacia dónde va el sucesor de Argon en la API de Gemini, y como motivo para que los equipos que usan Gemini mantengan sus presupuestos. Para todos los demás, la decisión es la misma que la semana pasada. Opus 5.5 es el modelo puntero que de verdad puedes comprar, a un punto del líder, y cambiar más adelante cuesta menos que esperar una fecha que Google no ha fijado.