
Gemini 4 Carbon prend la tête du classement. Vous ne pouvez pas encore l'utiliser
Par Andrew Miller ·
Vous avez un projet à livrer ce mois-ci et un modèle à choisir pour le mener. Le modèle en tête du classement cette semaine est un modèle que vous ne pouvez presque certainement pas utiliser. Gemini 4 Carbon, annoncé par Google le 28 octobre, n'est ouvert qu'à un petit groupe d'équipes de sécurité triées sur le volet, sans date pour les autres. Voici ce qu'il change, et ce qu'il ne change pas, pour un choix que vous devez faire aujourd'hui.
Ce que Google a publié, et pour qui
Carbon est le nouveau modèle phare de Google DeepMind, arrivé deux semaines après que Gemini 4 Argon a été proposé aux abonnés payants. Google a renoncé à une sortie générale à cause de ses compétences en sécurité. Un modèle doué pour trouver et corriger des failles dans les logiciels est aussi doué pour s'introduire dans les systèmes.
Pour l'instant, il est donc réservé à une partie des défenseurs en cybersécurité de Fairwind, le programme sur invitation de Google, et aux équipes internes de Google. Selon NeuralTrust, les candidatures passent par une équipe de compte Google Cloud, avec vérification des antécédents. Tous les autres se sont vu promettre un accès « dès que possible ».
Il n'y a ni identifiant de modèle public, ni fiche de modèle, ni limites publiées par Google. Au 1er novembre, les pages des modèles et des tarifs de l'API Gemini ne mentionnent qu'Argon dans la famille Gemini 4.
En tête du classement, d'un seul point
Sur l'Artificial Analysis Intelligence Index, un score indépendant construit à partir de nombreux tests, Carbon obtient 59. Claude Opus 5.5 obtient 58 à son réglage d'effort maximal, GPT-6 Astra 57 et Argon 50. Claude Fable 5.1, le modèle le plus cher d'Anthropic, culmine à 50, et Claude Sonnet 5.5 à 54.
Un point, c'est une avance mince. Le deuxième testeur indépendant, Vals, place Carbon deuxième de son propre indice avec 70,36 %, derrière Sonnet 5.5 à 70,85 % et juste devant Opus 5.5 à 70,18 %, tous dans sa marge d'erreur d'environ un point. Carbon domine nettement deux classements spécialisés de Vals : la finance (66,35 %) et la recherche juridique (55,77 %).
Le résumé honnête est une égalité à trois en tête, Carbon ayant une courte avance sur un seul tableau.
Programmation et agents : pas le leader
Le tableau de lancement de Google, autodéclaré et sans marges d'erreur, revendique le meilleur score sur 15 des 17 lignes. Les deux qu'il concède sont celles qui comptent le plus pour les développeurs. Sur FrontierSWE 2, un test de génie logiciel réel, Carbon obtient 61,2 % contre 65,5 % pour Astra et 62,3 % pour Opus. Sur OSWorld, où le modèle utilise un ordinateur seul, il obtient 81,5 % contre 87,2 % pour Opus.
Les chiffres autodéclarés des concurrents vont dans le même sens. Anthropic annonce 66,4 % pour Opus 5.5 sur Terminal-Bench 4.0, un test d'agents travaillant en ligne de commande, contre 57,9 % pour Astra et 55,8 % pour Fable 5.1. Google annonçait 57,4 % pour Argon sur le même test.
L'avance la plus nette de Carbon dans le tableau de Google porte sur la lecture d'entrées très longues : 96,2 % sur GraphWalks, contre 71,8 % pour Astra et 66,8 % pour Opus. Si votre travail consiste à interroger d'un coup toute une base de code ou toute une data room, c'est le chiffre à surveiller.
Moins de réponses inventées, mais plus qu'Argon
L'hallucination, quand un modèle affirme avec assurance quelque chose de faux, est le domaine où l'avance de Carbon est la plus large. Sur le test Omniscience d'Artificial Analysis, il invente dans 11 % des cas, selon VentureBeat, contre 50 % pour Opus 5.5 comme pour Astra.
Cela contredit une partie du récit de Google. Google affirme que Carbon fait environ moitié moins d'affirmations non étayées qu'Argon, or sur le même test le taux d'Argon était de 4 %. Carbon répond correctement à davantage de questions, 58 % contre 48 %, mais il devine plus souvent quand il ne sait pas.
Le prix, et la facture par tâche
Google a annoncé Carbon aux mêmes tarifs qu'Argon : un tarif de lancement de 2 $ par million de tokens d'entrée et 10 $ par million en sortie, puis 4 $ et 20 $. Le tarif de lancement d'Argon prend fin le 30 novembre ; Google n'a pas dit quand celui de Carbon prendrait fin.
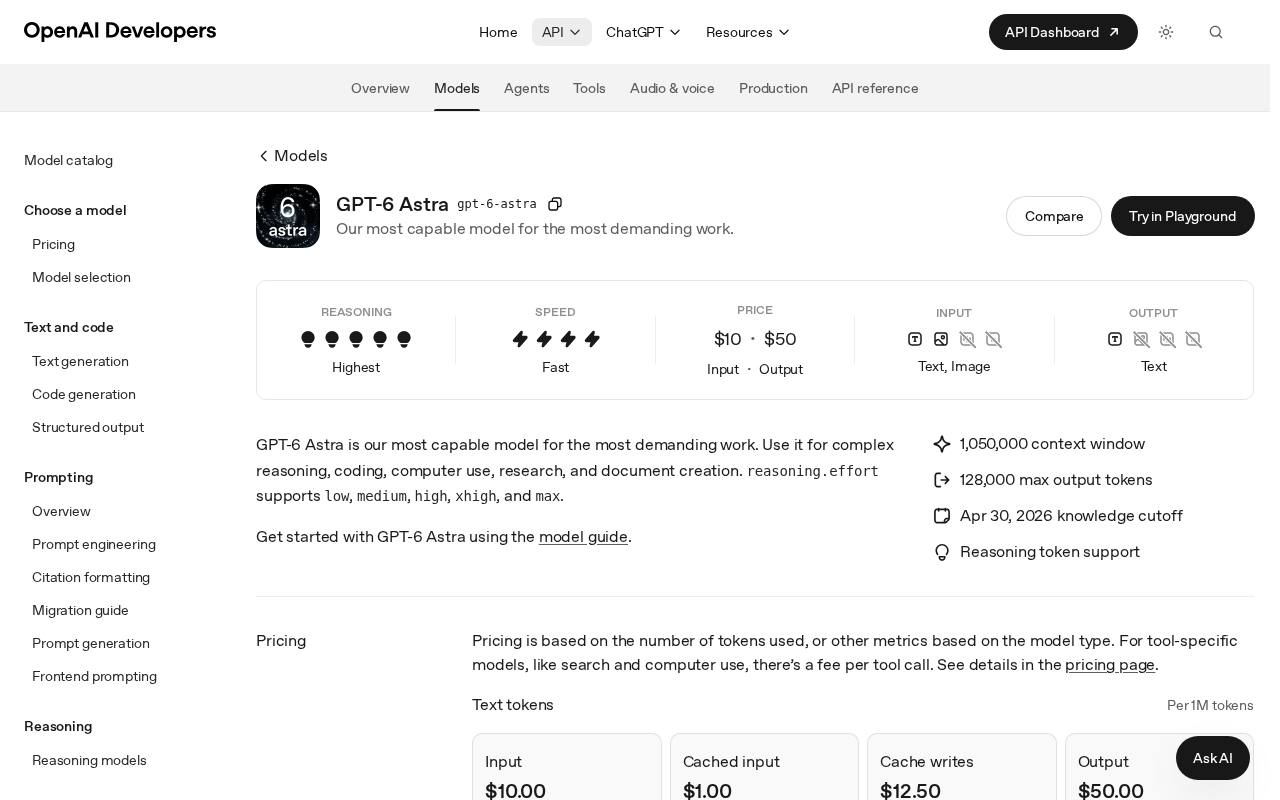
À 4 $/20 $, les deux modèles Gemini s'alignent sur Opus 5.5 par token. Fable 5.1 et Astra coûtent 10 $ et 50 $, soit deux fois et demie plus.
Les prix par token sont trompeurs, car les modèles n'écrivent pas tous autant. Carbon a utilisé 200 millions de tokens de sortie pour passer l'indice d'Artificial Analysis, contre une médiane de 70 millions. Au tarif ultérieur, cela revient à 7,76 $ par tâche de l'indice, contre 7,68 $ pour Argon, 10,04 $ pour Opus 5.5 et 6,25 $ pour Astra. Carbon est moins cher par tâche qu'Opus, mais pas autant que le nombre de tokens seul le laisse penser.
La vitesse : deux minutes d'attente
Artificial Analysis mesure 118,58 secondes avant l'apparition du premier mot de Carbon, contre une médiane de 3,71 secondes. Argon met 49,13 secondes.
Les concurrents sont lents eux aussi à leurs réglages maximaux, d'où viennent leurs meilleurs scores. Sur le même classement, Opus 5.5 en effort maximal attend 729,62 secondes et Astra au maximum 270,03. En effort moyen, ils descendent à 16,41 et 5,07 secondes, avec des scores plus bas. À pleine puissance, chacun de ces modèles convient à une tâche que l'on confie et à laquelle on revient plus tard, pas à une fenêtre de chat.
Le hic : tous les chiffres de Carbon ci-dessus viennent de testeurs bénéficiant d'un accès anticipé et du tableau de Google lui-même. Personne en dehors de Fairwind ne peut les vérifier sur son propre travail, Google n'a pas dit si le modèle public final correspondra à celui testé, et ses conditions de conservation et d'entraînement ne sont pas publiées. Une victoire au classement pour un modèle que vous ne pouvez pas appeler est une prévision, pas un produit.
Lequel pour quelle tâche
- Longues tâches de programmation et d'agents : Claude Opus 5.5. Il est en tête sur Terminal-Bench 4.0 et OSWorld, à un point de Carbon sur l'indice, et il est en vente sur cinq plateformes dès aujourd'hui.
- La plupart des travaux de production avec un budget serré : Claude Sonnet 5.5 ou GPT-6.1 Sol, tous deux à 2 $/10 $. Sonnet est en tête de l'indice de Vals ; Sol obtient 55 sur Artificial Analysis en effort maximal.
- Vidéo, audio et piles de PDF : Gemini 4 Argon, qui lit tout cela nativement dans une fenêtre de 1M de tokens. Prévoyez le doublement du prix au 1er décembre.
- Mathématiques et sciences de niveau recherche : GPT-6 Astra, auquel OpenAI attribue 64,6 % sur Terminal-Bench Science, contre 52,6 % pour Fable 5.1.
- Le raisonnement le plus difficile, une fois qu'Opus n'a pas suffi : Claude Fable 5.1. La documentation d'Anthropic elle-même recommande désormais de commencer par Opus.
- Équipes de sécurité triées sur le volet : Gemini 4 Carbon via Fairwind, ou GPT-5.6-Cyber via le programme Daybreak Red d'OpenAI.
- Des prix plus bas : Kimi K3.1 Pro à 2 $/10 $, avec des poids ouverts promis d'ici le 4 novembre.
Notre avis : Carbon compte surtout comme un signal de la direction que prend le successeur d'Argon dans l'API Gemini, et comme une raison pour les équipes Gemini de maintenir leurs budgets. Pour tous les autres, la décision est la même que la semaine dernière. Opus 5.5 est le modèle de pointe que vous pouvez réellement acheter, à un point du leader, et changer plus tard coûte moins cher qu'attendre une date que Google n'a pas fixée.