
Analysen Agenten-Frameworks und Automatisierung
Neu diese Woche: die Infrastruktur, die KI-Agenten in ihrer Spur hält
Von Sheela ·
Sobald ein Agent Code schreiben, Webseiten öffnen und deine Datenbank abfragen kann, zählt das Modell weniger als zwei schlichtere Fragen: Worauf darf er zugreifen, und kannst du sehen, was er getan hat? Acht Tools, die wir am 31. Oktober und 1. November getestet haben, beantworten sie von verschiedenen Seiten: eine Sandbox, ein Browser für Maschinen, ein Branch pro Agent, ein Skill-Scanner, eine vorsichtige Datenbankverbindung und drei Wege, aufzuzeichnen, zu bewerten und zu typisieren, was das Modell zurückschickt. Keines ist glamourös. Jedes beseitigt eine bestimmte Art, wie ein Agent-Lauf schiefgeht.
Ein sicherer Ort zum Ausführen
Ein Agent, der Code schreibt, ist nur nützlich, wenn er diesen Code ausführen kann. E2B (4,4) vermietet dir für jede Sitzung einen Linux-Rechner zum Wegwerfen. Jeder ist eine Firecracker-microVM, eine kleine virtuelle Maschine mit eigenem Kernel, und lässt sich mit intaktem Arbeitsspeicher und Datenträger pausieren. Die Standardmaschine mit 2 vCPUs und 4 GiB kostet etwa 0,17 $ pro Stunde, sekundengenau abgerechnet, und der kostenlose Hobby-Tarif kommt mit einem einmaligen Guthaben von 100 $.
Der Haken: Die Voreinstellungen begünstigen Bequemlichkeit. Jede Sandbox hat ausgehenden Internetzugang, und ihre öffentlichen URLs antworten jedem, der den Link hat, bis du sie einschränkst. GPUs gibt es nicht.
Die meisten Agenten, die surfen, müssen eine Seite nie sehen, nur ihr JavaScript ausführen und das Ergebnis lesen. Lightpanda (4,2) ist ein von Grund auf in Zig geschriebener Headless-Browser, der den Teil weglässt, der Pixel malt, und dasselbe DevTools Protocol spricht wie Chrome, sodass ein bestehendes Puppeteer- oder Playwright-Skript meist nur eine neue Adresse braucht. Im eigenen Benchmark des Projekts lag der Spitzenspeicher über 100 Seiten bei 123 MB gegenüber 2 GB für Headless Chrome. Das sind selbst gemeldete Seitenaufrufe, keine langen Klick-Sitzungen, aber schon ein Teil dieses Abstands bedeutet viel mehr Agenten pro Maschine.
Der Haken: Es ist eine junge Engine. Eine Website, die auf eine Webfunktion setzt, die Lightpanda noch nicht gebaut hat, scheitert, wo Chrome es nicht täte, also halte für die Ausreißer einen Chrome-Pool bereit. Telemetrie ist aktiv, bis du LIGHTPANDA_DISABLE_TELEMETRY=true setzt.
Grenzen dessen, worauf er zugreifen kann
Fünf Coding-Agenten auf einem Repository laufen zu lassen geht in dem Moment schief, in dem zwei davon dieselben Dateien bearbeiten. Git-Worktrees beheben das, indem sie jedem Agenten einen eigenen Ordner geben, aber Gits eigene Befehle lassen dich den Branch-Namen dreimal tippen. Worktrunk (4,4) lässt Worktrees sich wie Branches verhalten: Ein einziger Befehl wt legt Branch und Ordner an und startet den Agenten darin. Auf APFS, btrfs und XFS teilt es node_modules und target/ zwischen Worktrees, sodass zehn Agenten nicht zehn Builds von Grund auf bedeuten. Es ist kostenlos und hat etwa 9.700 GitHub-Sterne.
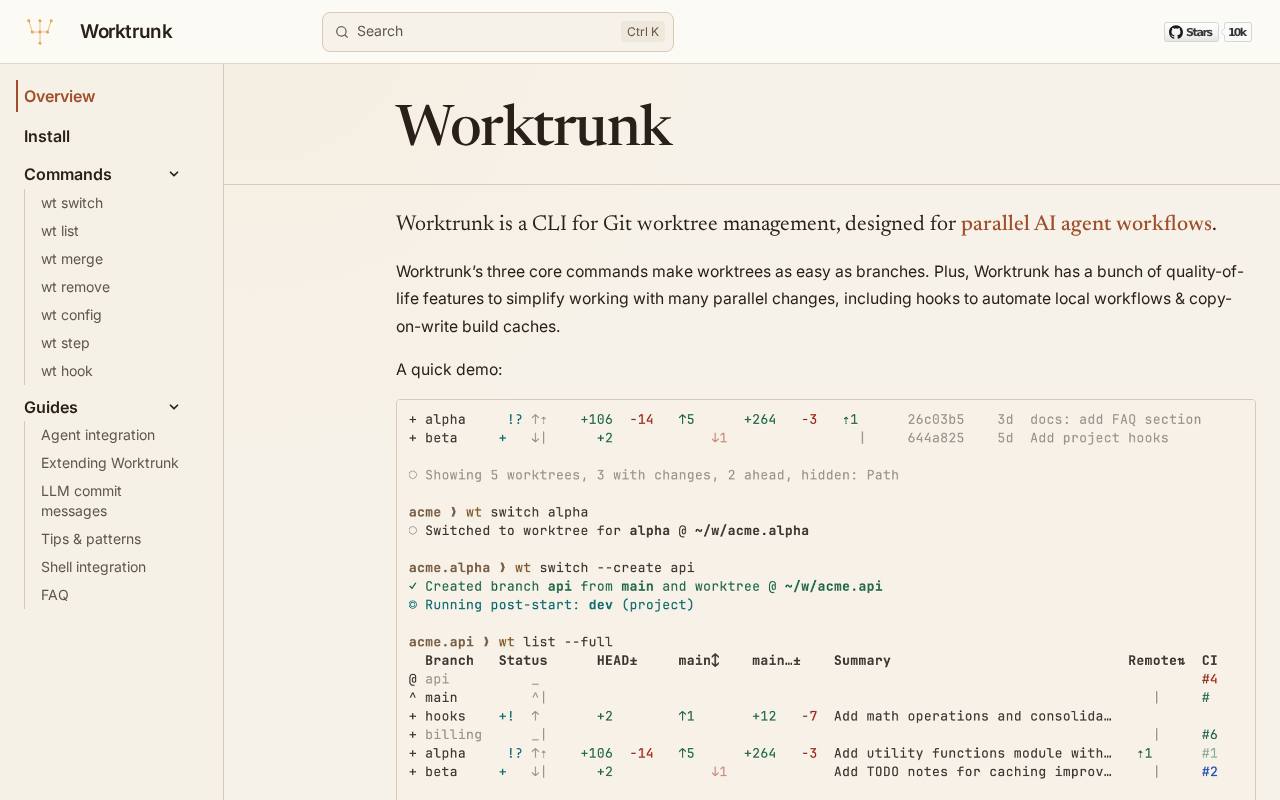
Der Haken: Es verwaltet Ordner, keine Agenten. Merge-Konflikte zwischen parallelen Branches bleiben deine Sache, und bei Version 0.81 können sich seine Flags und Einstellungen noch ändern.
Agent Skills sind Ordner mit Anweisungen und Skripten, die du in Claude Code oder Codex legst, und ein schlechter kann Anweisungen verstecken oder deine Keys woandershin schicken. NVIDIAs SkillSpector (4,1) liest einen Skill vor der Installation genau, anhand von 71 Mustern in 17 Kategorien, ohne ihn je auszuführen, und liefert einen Risikowert von 0 bis 100 mit einer klaren Empfehlung: SAFE, CAUTION oder DO NOT INSTALL.
Der Haken: Seine optionale KI-Prüfstufe ist standardmäßig eingeschaltet und schickt die Dateien des Skills an build.nvidia.com, sofern du nicht den Anbieter änderst oder --no-llm übergibst. NVIDIA veröffentlicht keine Erkennungs- oder Fehlalarmquote, und der Standard-Exit-Code lässt ein CAUTION-Ergebnis durch, eine strenge Schranke braucht also --fail-on-findings.
Eine Datenbankverbindung ist der Ort, an dem eine gekaperte Anweisung den meisten Schaden anrichtet. Microsofts Postgres-MCP-Server (4,0) in der Preview funktioniert mit jedem PostgreSQL, nicht nur mit Azure, hält Passwörter im Schlüsselbund deines Betriebssystems statt in der Konfigurationsdatei des Agenten und trennt Lesen von Schreiben: Das Abfrage-Tool nimmt jeweils eine einzige lesende Anweisung an, und ein auf Nur-Lesen gestelltes Profil sperrt das Schreib-Tool. Seine Dokumentation sagt offen, es sei „a gateway, not a policy engine“, was also die Datenbankrolle darf, darf auch der Agent. Das Paket verzeichnete in der Woche bis zum 29. Oktober 27.344 npm-Downloads.
Der Haken: Neue Profile erlauben Schreibzugriffe, sofern du sie nicht auf Nur-Lesen stellst, Tool-Namen haben sich in v0.2.0 geändert, und Telemetrie ist aktiv, bis du --no-telemetry übergibst.
Ein Protokoll dessen, was passiert ist, und Ausgaben, auf die du dich verlassen kannst
Wenn ein Agent eine schlechte Antwort gibt, willst du zuerst die Spur: welcher Prompt, welche Suche, welcher Tool-Aufruf. MLflow (4,4), lange der Standardort zum Protokollieren von Machine-Learning-Experimenten, zeichnet jetzt jeden Modellaufruf, jede Retrieval-Abfrage und jeden Tool-Aufruf als Trace auf, mit einer Zeile Einrichtung für OpenAI, Anthropic, LangChain und andere. Die gesamte Codebasis unter Apache 2.0 ist kostenlos, nichts ist einer bezahlten Lizenz vorbehalten, sie hat etwa 28.600 GitHub-Sterne und startet mit einer einzigen SQLite-Datei.
Der Haken: Der Server verlangt keine Anmeldung, sofern du ihn nicht mit Basic Authentication startest, und im Oktober ließ eine kritische Lücke Angreifer Code auf Servern ausführen, die so offen standen. Sie ist in 3.17.0 behoben; lass den Server trotzdem nie offen in einem geteilten Netzwerk.
Wenn deine Traces schon in Langfuse liegen, lässt sein eingebauter MCP-Server (4,2) einen Agenten sie lesen. Es gibt nichts zu installieren, und er bietet etwa 95 Tools für Prompts, Traces, Datensätze, Bewertungen und Dashboards.
Der Haken: Rate Limits. Im kostenlosen Hobby-Tarif teilen sich MCP-Aufrufe 30 Anfragen pro Minute mit jedem anderen API-Aufruf deiner Organisation, sodass ein Agent, der durch Traces blättert, an einer einzigen Frage hängen bleiben kann. Etwa die Hälfte der Tools verändert etwas, darunter solche, die Datensatzläufe löschen oder das Produktionslabel auf eine andere Prompt-Version verschieben, erlaube also nur die Lese-Tools, wenn du nur lesen musst.
Agenten brechen am häufigsten an der Nahtstelle, an der die Antwort des Modells sauberes JSON sein soll und es nicht ist. BAML (3,8) lässt dich Eingaben, Ausgabetyp und Prompt einer Funktion in einer Datei .baml deklarieren, erzeugt einen Client für deine App und repariert überzählige Kommas und halbfertige Objekte, statt sie abzulehnen. In Boundarys eigenem Benchmark mit 1.000 Fällen aus dem Berkeley Function Calling Leaderboard erreichte gpt-4o-mini mit dem Parser von BAML 92,4% gegenüber 19,8% mit nativem Function Calling. Die Zahlen sind selbst gemeldet und nutzen Modelle aus der Zeit von 2024.
Der Haken: Das Projekt ist gespalten zwischen einem alten v0 und einer neuen Sprache v1, die noch vor 1.0 steht, und allein die Release Notes von v1 0.21.0 listen 13 inkompatible Änderungen auf. Ein Team mit funktionierenden v0-Pipelines hat noch wenig Grund zu wechseln; ein neues Projekt setzt auf eine Sprache, die sich alle paar Wochen ändert.
Wo du anfangen solltest
Drei Gewohnheiten ziehen sich durch diese Testberichte. Erstens: Voreinstellungen sind offen: öffentliche Sandbox-URLs, Schreibzugriff, Server ohne Anmeldung, Telemetrie an. Nimm dir zehn Minuten, um sie vor allem anderen zu schließen; MLflows schlimmster Sicherheitshinweis in diesem Jahr traf genau die Server, die ohne Anmeldung liefen. Zweitens: Die günstigste Sicherheit ist Trennung, eine Sandbox, ein Worktree oder ein Nur-Lesen-Profil pro Agent, was fast nichts kostet und begrenzt, was ein schlechter Lauf kaputt machen kann. Drittens: Zeichne auf, bevor du es brauchst. Ein Trace, der letzte Woche eingeschaltet wurde, schlägt eine sorgfältige Untersuchung hinterher, und MLflow bewahrt ihn für den Preis eines kleinen Servers auf.