
이번 주 새로 리뷰한 도구: AI 에이전트를 제자리에 묶어 두는 기반 도구
작성자 Sheela ·
에이전트가 코드를 쓰고, 웹 페이지를 열고, 데이터베이스에 쿼리할 수 있게 되면, 모델보다 더 소박한 두 가지 질문이 중요해집니다. 무엇을 건드려도 되는가, 그리고 무엇을 했는지 볼 수 있는가입니다. 10월 31일과 11월 1일에 리뷰한 도구 여덟 개는 서로 다른 방향에서 이 질문에 답합니다. 샌드박스, 기계를 위해 만든 브라우저, 에이전트마다 하나씩인 브랜치, 스킬 스캐너, 신중한 데이터베이스 연결, 그리고 모델이 돌려보내는 것을 기록하고 평가하고 타입을 지정하는 세 가지 방법입니다. 화려한 것은 없습니다. 저마다 에이전트 실행이 잘못되는 특정한 경로 하나를 없앱니다.
안전하게 실행할 곳
코드를 쓰는 에이전트는 그 코드를 실행할 수 있어야 쓸모가 있습니다. E2B(4.4)는 세션마다 쓰고 버리는 Linux 컴퓨터를 빌려줍니다. 각각은 자체 커널을 가진 작은 가상 머신인 Firecracker microVM이며, 메모리와 디스크를 그대로 둔 채 일시 정지할 수 있습니다. 2 vCPU와 4 GiB의 기본 머신은 시간당 약 $0.17로 초 단위 과금되며, 무료 Hobby 요금제에는 1회성 $100 크레딧이 붙습니다.
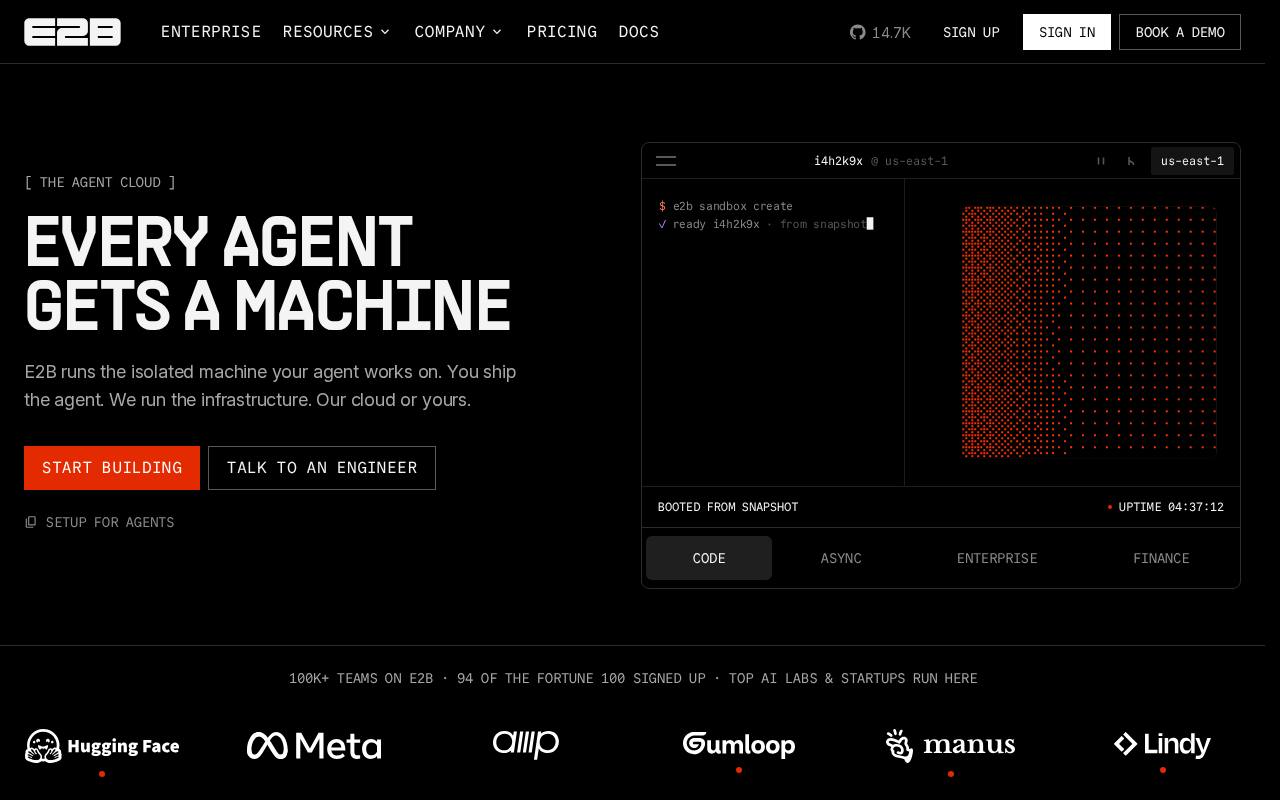
주의할 점: 기본값이 편의를 우선합니다. 모든 샌드박스에 외부 인터넷 접속이 열려 있고, 공개 URL은 제한하기 전까지 링크를 가진 누구에게나 응답합니다. GPU는 없습니다.
웹을 탐색하는 에이전트 대부분은 페이지를 볼 필요가 없고, JavaScript를 실행해 결과를 읽기만 하면 됩니다. Lightpanda(4.2)는 Zig로 처음부터 새로 쓴 헤드리스 브라우저로, 픽셀을 그리는 부분을 빼고 Chrome과 같은 DevTools Protocol을 씁니다. 그래서 기존 Puppeteer나 Playwright 스크립트는 대개 주소만 바꾸면 됩니다. 프로젝트 자체 벤치마크에서 100개 페이지에 대한 최대 메모리는 123 MB로, 헤드리스 Chrome의 2 GB와 대비됩니다. 이는 자체 보고한 페이지 로드 수치이지 긴 클릭 세션이 아니지만, 그 차이의 일부만 맞아도 머신 한 대당 훨씬 많은 에이전트를 돌릴 수 있습니다.
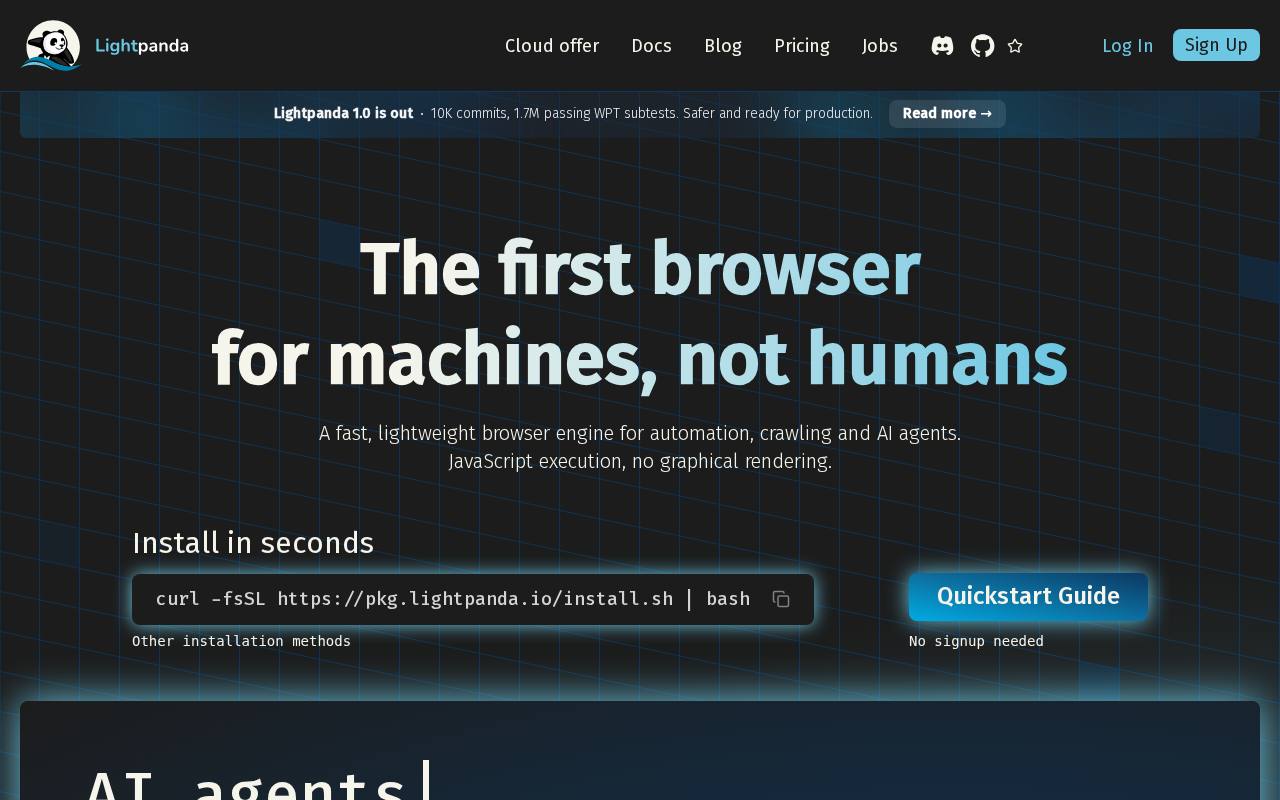
주의할 점: 젊은 엔진입니다. Lightpanda가 아직 구현하지 않은 웹 기능에 기대는 사이트는 Chrome이라면 되는 곳에서 실패하므로, 맞지 않는 사이트를 위해 Chrome 풀을 남겨 두십시오. 원격 측정은 LIGHTPANDA_DISABLE_TELEMETRY=true를 설정하기 전까지 켜져 있습니다.
건드릴 수 있는 범위의 제한
저장소 하나에서 코딩 에이전트 다섯 개를 돌리면, 둘이 같은 파일을 고치는 순간 문제가 생깁니다. Git 워크트리는 에이전트마다 자체 폴더를 주어 이를 해결하지만, git 자체 명령으로는 브랜치 이름을 세 번 입력해야 합니다. Worktrunk(4.4)는 워크트리를 브랜치처럼 다루게 합니다. wt 명령 하나로 브랜치와 폴더를 만들고 그 안에서 에이전트를 시작합니다. APFS, btrfs, XFS에서는 워크트리 사이에 node_modules와 target/를 공유하므로, 에이전트 열 개가 빌드 열 번을 처음부터 한다는 뜻이 되지 않습니다. 무료이고 GitHub 별은 약 9,700개입니다.
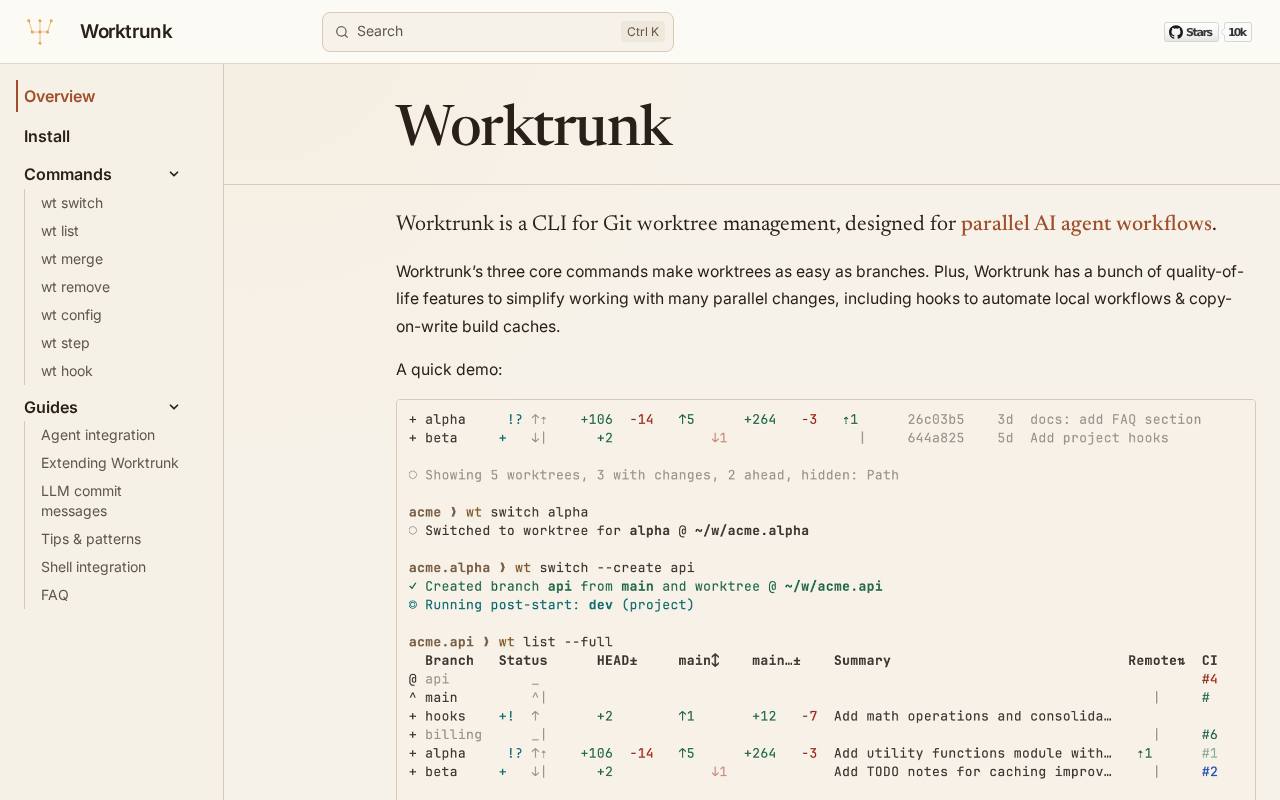
주의할 점: 에이전트가 아니라 폴더를 관리합니다. 병렬 브랜치 사이의 병합 충돌은 여전히 직접 해결해야 하고, 버전 0.81인 지금은 플래그와 설정이 아직 바뀔 수 있습니다.
에이전트 스킬은 Claude Code나 Codex에 넣는 지침과 스크립트 폴더이며, 나쁜 스킬은 지침을 숨기거나 키를 다른 곳으로 보낼 수 있습니다. NVIDIA의 SkillSpector(4.1)는 설치 전에 스킬 하나를 17개 범주의 71개 패턴에 비추어 꼼꼼히 읽으며, 한 번도 실행하지 않습니다. 그리고 0에서 100까지의 위험 점수와 함께 SAFE, CAUTION, DO NOT INSTALL이라는 분명한 권고를 돌려줍니다.
주의할 점: 선택 사항인 AI 검토 단계가 기본으로 켜져 있어, 공급자를 바꾸거나 --no-llm을 넘기지 않으면 스킬 파일을 build.nvidia.com으로 보냅니다. NVIDIA는 탐지율이나 오탐률을 공개하지 않으며, 기본 종료 코드는 CAUTION 결과를 통과시키므로 엄격한 관문을 원하면 --fail-on-findings가 필요합니다.
데이터베이스 연결은 탈취된 지침이 가장 큰 피해를 내는 곳입니다. Microsoft의 프리뷰 Postgres MCP server(4.0)는 Azure뿐 아니라 모든 PostgreSQL에서 작동하고, 비밀번호를 에이전트 설정 파일이 아니라 운영체제의 키링에 보관하며, 읽기와 쓰기를 분리합니다. 쿼리 도구는 한 번에 읽기 전용 문 하나만 받고, 읽기 전용으로 설정한 프로필은 쓰기 도구를 막습니다. 문서는 이것이 "정책 엔진이 아니라 게이트웨이"라고 솔직하게 밝히므로, 데이터베이스 역할이 할 수 있는 일은 에이전트도 할 수 있습니다. 이 패키지는 10월 29일까지 한 주 동안 npm에서 27,344회 다운로드되었습니다.
주의할 점: 새 프로필은 읽기 전용으로 설정하지 않으면 쓰기를 허용하고, v0.2.0에서 도구 이름이 바뀌었으며, 원격 측정은 --no-telemetry를 넘기기 전까지 켜져 있습니다.
무슨 일이 있었는지의 기록, 그리고 믿을 수 있는 출력
에이전트가 나쁜 답을 내면 가장 먼저 원하는 것은 흔적입니다. 어떤 프롬프트, 어떤 검색, 어떤 도구 호출이었는지입니다. 오랫동안 머신러닝 실험을 기록하는 기본 장소였던 MLflow(4.4)는 이제 모델 호출, 검색, 도구 호출을 각각 트레이스로 기록하며, OpenAI, Anthropic, LangChain 등은 설정 한 줄이면 됩니다. Apache-2.0 코드베이스 전체가 무료이고 유료 라이선스용으로 남겨 둔 것이 없으며, GitHub 별은 약 28,600개이고, SQLite 파일 하나로 시작합니다.
주의할 점: 서버는 기본 인증으로 시작하지 않으면 로그인을 요구하지 않으며, 10월에는 그렇게 열어 둔 서버에서 공격자가 코드를 실행할 수 있는 치명적 결함이 있었습니다. 3.17.0에서 고쳐졌지만, 그래도 공유 네트워크에서 서버를 열어 두지 마십시오.
트레이스가 이미 Langfuse에 있다면, 그 내장 MCP 서버(4.2)로 에이전트가 트레이스를 읽을 수 있습니다. 설치할 것이 없고, 프롬프트, 트레이스, 데이터셋, 점수, 대시보드에 걸쳐 약 95개 도구를 제공합니다.
주의할 점: 속도 제한입니다. 무료 Hobby 요금제에서 MCP 호출은 조직의 다른 모든 API 호출과 분당 30회 요청을 나눠 쓰므로, 트레이스를 넘겨 보는 에이전트가 질문 하나에 멈출 수 있습니다. 도구의 절반가량은 무언가를 바꾸며, 데이터셋 실행을 삭제하거나 production 레이블을 다른 프롬프트 버전으로 옮기는 도구도 포함됩니다. 읽기만 필요하다면 읽기 도구만 허용하십시오.
에이전트가 가장 자주 깨지는 곳은 모델의 응답이 깨끗한 JSON이어야 하는데 그렇지 않은 이음매입니다. BAML(3.8)은 .baml 파일에 함수의 입력, 출력 타입, 프롬프트를 선언하게 하고, 앱용 클라이언트를 생성하며, 끝에 남은 쉼표나 덜 끝난 객체를 거부하는 대신 고칩니다. Boundary가 Berkeley Function Calling Leaderboard 사례 1,000개로 낸 자체 벤치마크에서 gpt-4o-mini는 BAML 파서로 92.4%를, 네이티브 함수 호출로 19.8%를 기록했습니다. 이 수치는 자체 보고이며 2024년 무렵의 모델을 썼습니다.
주의할 점: 프로젝트가 레거시 v0와 아직 1.0 이전인 새 v1 언어로 나뉘어 있고, v1 0.21.0 릴리스 노트에만 호환성을 깨는 변경이 13개 있습니다. 잘 돌아가는 v0 파이프라인이 있는 팀이 지금 옮길 이유는 별로 없고, 새 프로젝트는 몇 주마다 바뀌는 언어에 거는 셈입니다.
어디서 시작할까
이 리뷰들에는 세 가지 습관이 흐릅니다. 첫째, 기본값이 열려 있습니다. 공개 샌드박스 URL, 쓰기 권한, 로그인 없는 서버, 켜진 원격 측정입니다. 무엇보다 먼저 10분을 들여 이를 닫으십시오. 올해 MLflow의 가장 심각한 권고는 정확히 로그인 없이 둔 서버를 겨냥했습니다. 둘째, 가장 싼 안전장치는 분리입니다. 에이전트마다 샌드박스, 워크트리, 읽기 전용 프로필을 하나씩 두는 것은 거의 비용이 들지 않으면서 잘못된 실행 하나가 망가뜨릴 수 있는 범위를 제한합니다. 셋째, 필요해지기 전에 기록하십시오. 지난주에 켜 둔 트레이스가 나중의 꼼꼼한 조사보다 낫고, MLflow는 작은 서버 한 대 값으로 그것을 보관해 줍니다.