
Análises Frameworks de agentes e automação
Novidades da semana: a infraestrutura que mantém os agentes de IA na linha
Por Sheela ·
Quando um agente consegue escrever código, abrir páginas web e consultar o seu banco de dados, o modelo importa menos do que duas perguntas mais simples: o que ele pode tocar, e você consegue ver o que ele fez? Oito ferramentas que analisamos em 31 de outubro e 1º de novembro respondem a isso por lados diferentes: um sandbox, um navegador feito para máquinas, um branch por agente, um scanner de skills, uma conexão cuidadosa com o banco de dados e três formas de registrar, avaliar e tipar o que o modelo devolve. Nenhuma é glamorosa. Cada uma elimina uma forma específica de uma execução de agente dar errado.
Um lugar seguro para rodar
Um agente que escreve código só é útil se puder rodar esse código. O E2B (4,4) aluga para você um computador Linux descartável para cada sessão. Cada um é uma microVM Firecracker, uma pequena máquina virtual com kernel próprio, e pode ser pausada com memória e disco intactos. A máquina padrão, de 2 vCPUs e 4 GiB, custa cerca de US$ 0,17 por hora, cobrados por segundo, e o plano grátis Hobby vem com um crédito único de US$ 100.
O porém: os padrões favorecem a conveniência. Todo sandbox tem acesso de saída à internet, e suas URLs públicas respondem a qualquer pessoa que tenha o link até você restringi-las. Não há GPUs.
A maioria dos agentes que navegam nunca precisa ver uma página, só rodar o JavaScript dela e ler o resultado. O Lightpanda (4,2) é um navegador headless escrito do zero em Zig que deixa de fora a parte que pinta pixels e fala o mesmo DevTools Protocol do Chrome, então um script existente de Puppeteer ou Playwright precisa, na maior parte, só de um endereço novo. No benchmark do próprio projeto, o pico de memória em 100 páginas foi de 123 MB contra 2 GB do Chrome headless. São carregamentos de página relatados pelo próprio projeto, não sessões longas de cliques, mas mesmo parte dessa diferença significa muito mais agentes por máquina.
O porém: é uma engine nova. Um site que depende de um recurso web que o Lightpanda ainda não implementou vai falhar onde o Chrome não falharia, então mantenha um pool de Chrome para os casos difíceis. A telemetria fica ligada até você definir LIGHTPANDA_DISABLE_TELEMETRY=true.
Limites para o que ele pode tocar
Rodar cinco agentes de programação em um repositório dá errado no momento em que dois deles editam os mesmos arquivos. As git worktrees resolvem isso dando a cada agente sua própria pasta, mas os comandos do próprio git fazem você digitar o nome do branch três vezes. O Worktrunk (4,4) faz as worktrees se comportarem como branches: um único comando wt cria o branch e a pasta e inicia o agente dentro dela. Em APFS, btrfs e XFS, ele compartilha node_modules e target/ entre worktrees, então dez agentes não significam dez builds do zero. É grátis, com cerca de 9.700 estrelas no GitHub.
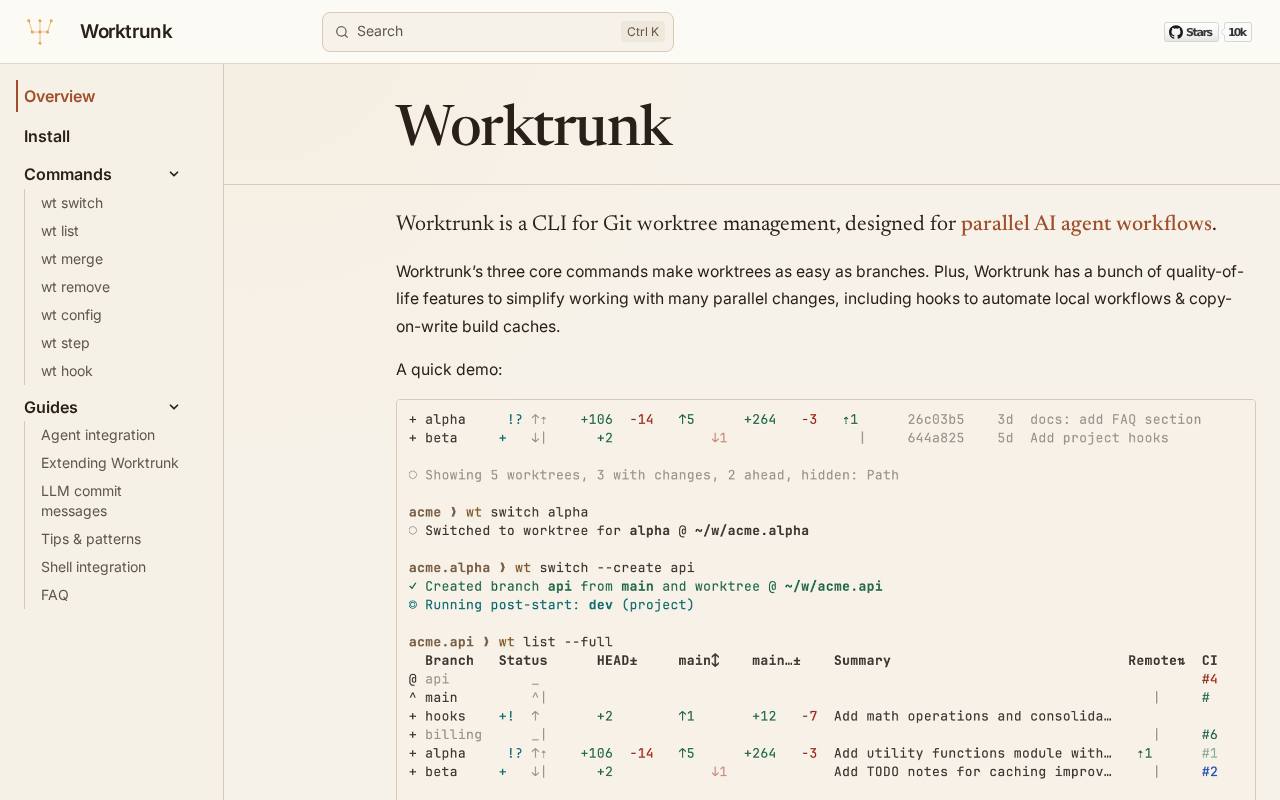
O porém: ele gerencia pastas, não agentes. Conflitos de merge entre branches paralelos continuam sendo seus, e na versão 0.81 suas flags e configurações ainda podem mudar.
Agent skills são pastas de instruções e scripts que você coloca no Claude Code ou no Codex, e uma ruim pode esconder instruções ou mandar suas chaves para outro lugar. O SkillSpector (4,1) da NVIDIA lê uma skill com atenção antes de você instalá-la, comparando-a com 71 padrões em 17 categorias, sem nunca executá-la, e devolve uma pontuação de risco de 0 a 100 com uma recomendação direta: SAFE, CAUTION ou DO NOT INSTALL.
O porém: sua etapa opcional de revisão por IA vem ligada por padrão e envia os arquivos da skill para build.nvidia.com, a menos que você mude o provedor ou passe --no-llm. A NVIDIA não publica taxa de detecção nem de falsos alarmes, e o código de saída padrão deixa passar um resultado CAUTION, então uma barreira rígida exige --fail-on-findings.
Uma conexão com o banco de dados é onde uma instrução sequestrada causa mais estrago. O servidor MCP de Postgres (4,0) da Microsoft, em prévia, funciona com qualquer PostgreSQL, não só no Azure, guarda as senhas no keyring do seu sistema operacional em vez de no arquivo de configuração do agente e separa leitura de escrita: a ferramenta de consulta aceita uma instrução somente leitura por vez, e um perfil definido como somente leitura bloqueia a ferramenta de escrita. A documentação é franca ao dizer que ele é "um gateway, não um motor de políticas", então o que o papel no banco de dados puder fazer, o agente pode fazer. O pacote teve 27.344 downloads no npm na semana até 29 de outubro.
O porém: perfis novos permitem escrita, a menos que você os defina como somente leitura, os nomes das ferramentas mudaram na v0.2.0, e a telemetria fica ligada até você passar --no-telemetry.
Um registro do que aconteceu, e uma saída em que você pode confiar
Quando um agente dá uma resposta ruim, a primeira coisa que você quer é o rastro: qual prompt, qual busca, qual chamada de ferramenta. O MLflow (4,4), há muito tempo o lugar padrão para registrar experimentos de machine learning, agora grava cada chamada ao modelo, recuperação e chamada de ferramenta como um trace, com uma linha de configuração para OpenAI, Anthropic, LangChain e outros. Toda a base de código Apache-2.0 é grátis, sem nada reservado para uma licença paga, tem cerca de 28.600 estrelas no GitHub e começa com um único arquivo SQLite.
O porém: o servidor não pede login, a menos que você o inicie com autenticação básica, e em outubro uma falha crítica permitiu que atacantes executassem código em servidores deixados abertos assim. Foi corrigida na 3.17.0; mesmo assim, nunca deixe o servidor aberto em uma rede compartilhada.
Se os seus traces já estão no Langfuse, o servidor MCP integrado (4,2) dele permite que um agente os leia. Não há nada para instalar, e ele oferece cerca de 95 ferramentas para prompts, traces, conjuntos de dados, pontuações e painéis.
O porém: limites de taxa. No plano grátis Hobby, as chamadas MCP dividem 30 requisições por minuto com todas as outras chamadas de API da sua organização, então um agente folheando traces pode travar em uma única pergunta. Cerca de metade das ferramentas altera coisas, incluindo algumas que excluem execuções de conjuntos de dados ou movem o rótulo de produção para outra versão de prompt, então libere só as ferramentas de leitura se ler for tudo de que você precisa.
Os agentes quebram com mais frequência na junção em que a resposta do modelo deveria ser um JSON limpo e não é. O BAML (3,8) permite declarar as entradas, o tipo de saída e o prompt de uma função em um arquivo .baml, gera um cliente para o seu app e conserta vírgulas sobrando e objetos pela metade em vez de rejeitá-los. No benchmark da própria Boundary, com 1.000 casos do Berkeley Function Calling Leaderboard, o gpt-4o-mini marcou 92,4% com o parser do BAML contra 19,8% com chamada de função nativa. Os números são autorrelatados e usam modelos da época de 2024.
O porém: o projeto está dividido entre uma v0 legada e uma nova linguagem v1 que ainda não chegou à 1.0, e só as notas da release 0.21.0 da v1 listam 13 mudanças incompatíveis. Uma equipe com pipelines v0 funcionando tem pouco motivo para migrar por enquanto; um projeto novo está apostando em uma linguagem que muda a cada poucas semanas.
Por onde começar
Três hábitos atravessam essas análises. Primeiro, os padrões são abertos: URLs públicas de sandbox, acesso de escrita, servidores sem login, telemetria ligada. Gaste dez minutos fechando isso antes de qualquer outra coisa; o pior alerta do MLflow neste ano atingiu justamente os servidores deixados sem login. Segundo, a segurança mais barata é a separação, um sandbox, uma worktree ou um perfil somente leitura por agente, o que quase não custa nada e limita o que uma execução ruim pode quebrar. Terceiro, registre antes de precisar. Um trace ligado na semana passada vale mais que uma investigação cuidadosa depois, e o MLflow o guarda pelo preço de um servidor pequeno.