
Analyses Frameworks d'agents et automatisation
Nouveau cette semaine : la tuyauterie qui garde les agents IA dans leur couloir
Par Sheela ·
Dès qu'un agent peut écrire du code, ouvrir des pages web et interroger votre base de données, le modèle compte moins que deux questions plus terre à terre : à quoi a-t-il le droit de toucher, et pouvez-vous voir ce qu'il a fait ? Huit outils testés les 31 octobre et 1er novembre y répondent sous différents angles : un bac à sable, un navigateur conçu pour les machines, une branche par agent, un scanner de skills, une connexion prudente à la base de données, et trois façons d'enregistrer, d'évaluer et de typer ce que renvoie le modèle. Aucun n'est glamour. Chacun supprime une façon précise dont l'exécution d'un agent tourne mal.
Un endroit sûr où s'exécuter
Un agent qui écrit du code n'est utile que s'il peut exécuter ce code. E2B (4,4) vous loue un ordinateur Linux jetable pour chaque session. Chacun est une microVM Firecracker, une petite machine virtuelle avec son propre noyau, qui peut être mise en pause avec sa mémoire et son disque intacts. La machine par défaut de 2 vCPU et 4 GiB coûte environ 0,17 $ de l'heure, facturée à la seconde, et le forfait gratuit Hobby comprend un crédit unique de 100 $.
Le hic : les réglages par défaut privilégient la commodité. Chaque bac à sable a un accès internet sortant, et ses URL publiques répondent à quiconque possède le lien tant que vous ne les restreignez pas. Il n'y a pas de GPU.
La plupart des agents qui naviguent n'ont jamais besoin de voir une page, seulement d'exécuter son JavaScript et d'en lire le résultat. Lightpanda (4,2) est un navigateur headless écrit de zéro en Zig qui laisse de côté la partie qui dessine les pixels et parle le même DevTools Protocol que Chrome : un script Puppeteer ou Playwright existant n'a le plus souvent besoin que d'une nouvelle adresse. Sur le propre benchmark du projet, la mémoire maximale sur 100 pages était de 123 MB contre 2 GB pour Chrome headless. Il s'agit de chargements de pages autodéclarés, pas de longues sessions de navigation à coups de clics, mais même une partie de cet écart signifie beaucoup plus d'agents par machine.
Le hic : c'est un moteur jeune. Un site qui s'appuie sur une fonction web que Lightpanda n'a pas encore implémentée échouera là où Chrome fonctionnerait : gardez un pool de Chrome pour les cas récalcitrants. La télémétrie est active tant que vous ne définissez pas LIGHTPANDA_DISABLE_TELEMETRY=true.
Des limites à ce qu'il peut toucher
Faire tourner cinq agents de programmation sur un même dépôt tourne mal dès que deux d'entre eux modifient les mêmes fichiers. Les worktrees git règlent ce problème en donnant à chaque agent son propre dossier, mais les commandes de git vous obligent à taper trois fois le nom de la branche. Worktrunk (4,4) fait fonctionner les worktrees comme des branches : une seule commande wt crée la branche et le dossier et y lance l'agent. Sur APFS, btrfs et XFS, il partage node_modules et target/ entre les worktrees : dix agents ne signifient donc pas dix compilations à partir de zéro. Il est gratuit, avec environ 9 700 étoiles sur GitHub.
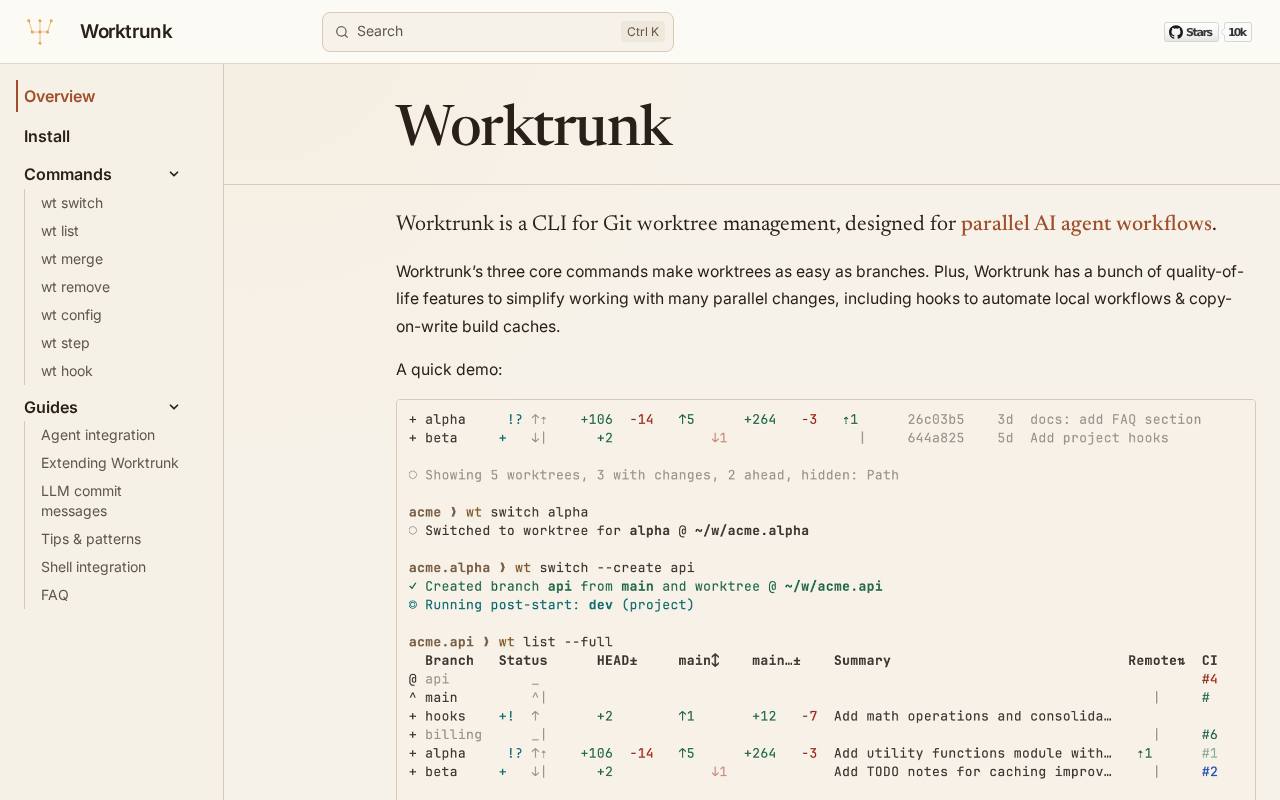
Le hic : il gère des dossiers, pas des agents. Les conflits de fusion entre branches parallèles restent à votre charge, et en version 0.81 ses options et ses réglages peuvent encore changer.
Les skills d'agent sont des dossiers d'instructions et de scripts que vous déposez dans Claude Code ou Codex, et une skill malveillante peut cacher des instructions ou envoyer vos clés ailleurs. SkillSpector (4,1), de NVIDIA, examine de près une skill avant que vous l'installiez, en la confrontant à 71 motifs répartis en 17 catégories, sans jamais l'exécuter, et renvoie un score de risque de 0 à 100 avec une recommandation claire : SAFE, CAUTION ou DO NOT INSTALL.
Le hic : son étape facultative de revue par IA est activée par défaut et envoie les fichiers de la skill à build.nvidia.com, sauf si vous changez de fournisseur ou passez --no-llm. NVIDIA ne publie aucun taux de détection ni de fausses alertes, et le code de sortie par défaut laisse passer un résultat CAUTION : un contrôle strict exige --fail-on-findings.
Une connexion à une base de données est l'endroit où une instruction détournée fait le plus de dégâts. Le serveur MCP Postgres (4,0) de Microsoft, en préversion, fonctionne avec n'importe quel PostgreSQL, pas seulement Azure, conserve les mots de passe dans le trousseau de votre système d'exploitation plutôt que dans le fichier de configuration de l'agent, et sépare la lecture de l'écriture : l'outil de requête accepte une seule instruction en lecture seule à la fois, et un profil réglé en lecture seule bloque l'outil d'écriture. Sa documentation dit franchement qu'il est « une passerelle, pas un moteur de politiques » : tout ce que le rôle de base de données peut faire, l'agent peut le faire. Le paquet a été téléchargé 27 344 fois sur npm la semaine précédant le 29 octobre.
Le hic : les nouveaux profils autorisent l'écriture tant que vous ne les réglez pas en lecture seule, les noms des outils ont changé en v0.2.0, et la télémétrie est active tant que vous ne passez pas --no-telemetry.
Une trace de ce qui s'est passé, et des sorties fiables
Quand un agent donne une mauvaise réponse, la première chose que vous voulez, c'est la piste : quelle consigne, quelle recherche, quel appel d'outil. MLflow (4,4), longtemps l'outil par défaut pour consigner les expériences d'apprentissage automatique, enregistre désormais chaque appel de modèle, chaque récupération et chaque appel d'outil sous forme de trace, avec une seule ligne de configuration pour OpenAI, Anthropic, LangChain et d'autres. Toute la base de code sous Apache-2.0 est gratuite, sans rien de réservé à une licence payante, elle compte environ 28 600 étoiles sur GitHub, et elle démarre sur un simple fichier SQLite.
Le hic : le serveur ne demande aucune connexion tant que vous ne le lancez pas avec une authentification basique, et en octobre une faille critique a permis à des attaquants d'exécuter du code sur des serveurs laissés ouverts de cette façon. Elle est corrigée en 3.17.0 ; malgré tout, ne laissez jamais le serveur ouvert sur un réseau partagé.
Si vos traces sont déjà dans Langfuse, son serveur MCP intégré (4,2) permet à un agent de les lire. Il n'y a rien à installer, et il propose environ 95 outils couvrant les consignes, les traces, les jeux de données, les scores et les tableaux de bord.
Le hic : les limites de débit. Sur le forfait gratuit Hobby, les appels MCP partagent 30 requêtes par minute avec tous les autres appels d'API de votre organisation : un agent qui parcourt des traces peut donc se bloquer sur une seule question. Environ la moitié des outils modifient des choses, dont certains qui suppriment des exécutions de jeux de données ou déplacent l'étiquette de production vers une autre version de consigne : n'autorisez que les outils de lecture si lire est tout ce dont vous avez besoin.
Les agents cassent le plus souvent à la jointure où la réponse du modèle est censée être du JSON propre et ne l'est pas. BAML (3,8) vous permet de déclarer les entrées d'une fonction, son type de sortie et sa consigne dans un fichier .baml, génère un client pour votre application, et répare les virgules finales et les objets inachevés au lieu de les rejeter. Sur le propre benchmark de Boundary portant sur 1 000 cas du Berkeley Function Calling Leaderboard, gpt-4o-mini a obtenu 92,4 % avec l'analyseur de BAML contre 19,8 % avec l'appel de fonctions natif. Les chiffres sont autodéclarés et portent sur des modèles de l'époque 2024.
Le hic : le projet est partagé entre une ancienne v0 et un nouveau langage v1 encore antérieur à la 1.0, et les seules notes de version de la v1 0.21.0 listent 13 changements incompatibles. Une équipe dont les pipelines v0 fonctionnent a peu de raisons de migrer pour l'instant ; un nouveau projet parie sur un langage qui change toutes les quelques semaines.
Par où commencer
Trois habitudes ressortent de ces tests. D'abord, les réglages par défaut sont ouverts : URL publiques de bacs à sable, accès en écriture, serveurs sans connexion, télémétrie active. Passez dix minutes à les fermer avant toute chose ; la pire alerte de sécurité de MLflow cette année a touché précisément les serveurs laissés sans connexion. Ensuite, la sécurité la moins chère est la séparation, un bac à sable, un worktree ou un profil en lecture seule par agent, ce qui ne coûte presque rien et limite ce qu'une mauvaise exécution peut casser. Enfin, enregistrez avant d'en avoir besoin. Une trace activée la semaine dernière vaut mieux qu'une enquête minutieuse après coup, et MLflow la conservera pour le prix d'un petit serveur.