
Análises Frameworks de agentes e automação
Protegendo o seu agente de programação: as cinco camadas, e quais ferramentas realmente bloqueiam algo
Por Sheela ·
O seu agente de programação lê arquivos, executa comandos e instala coisas em seu nome. A maioria das ferramentas populares de "segurança de IA" para ele só dá conselhos. Eis como empilhar as que realmente impedem algo, e onde entram as que aconselham.
A ideia é simples. Qualquer coisa que roda dentro do agente pode ser contornada na conversa, porque um prompt injection pode convencer o modelo a ignorá-la. Então as decisões que precisam se manter ficam fora do agente: no sistema operacional, em um hook ou na CI. As contagens de estrelas abaixo foram conferidas no GitHub em 24 de outubro de 2026, e dizem pouco sobre quais ferramentas impõem alguma coisa: a skill de auditoria da Cloudflare tem mais estrelas que todas as ferramentas de bloqueio daqui somadas, com 14 commits.
1. Conter: decida o que o agente pode alcançar
Se todo o resto falhar, um sandbox ainda decide quais arquivos o agente pode ler ou escrever e a quais hosts ele pode se conectar.
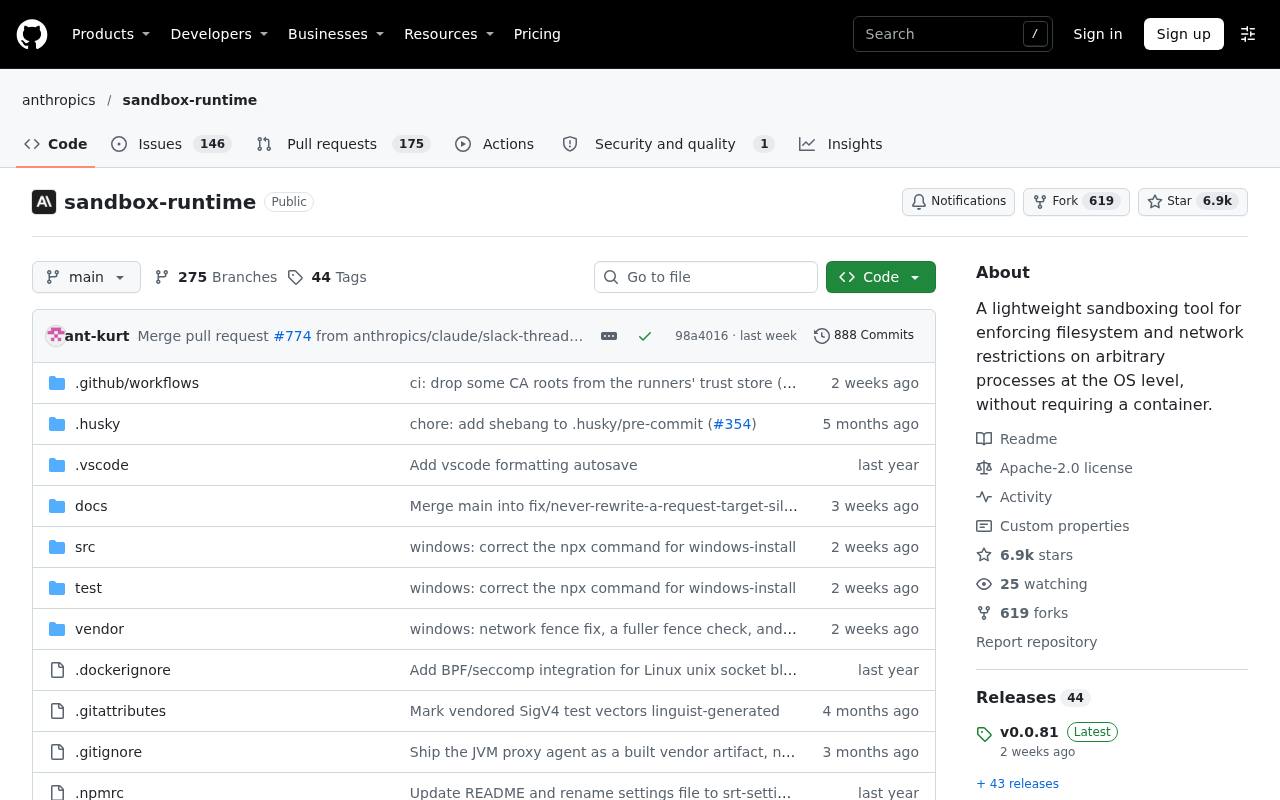
- O Anthropic Sandbox Runtime (4,4) é a engine por trás do
/sandboxdo Claude Code. Usa o sandbox do próprio sistema operacional, não precisa de contêiner e é grátis. Ele permite, de propósito, escrita dentro do seu projeto, então não vai impedir um hard reset. - O NVIDIA OpenShell (4,1) é mais pesado: um sandbox por agente, credenciais que o agente nunca vê e mudanças de política verificadas antes de serem aplicadas. Serve para agentes que você deixa rodando sem supervisão.
Escolha um por carga de trabalho. Rodar os dois no mesmo agente só lhe dá dois conjuntos de regras para depurar.
2. Proteger: bloqueie ações perigosas antes que rodem
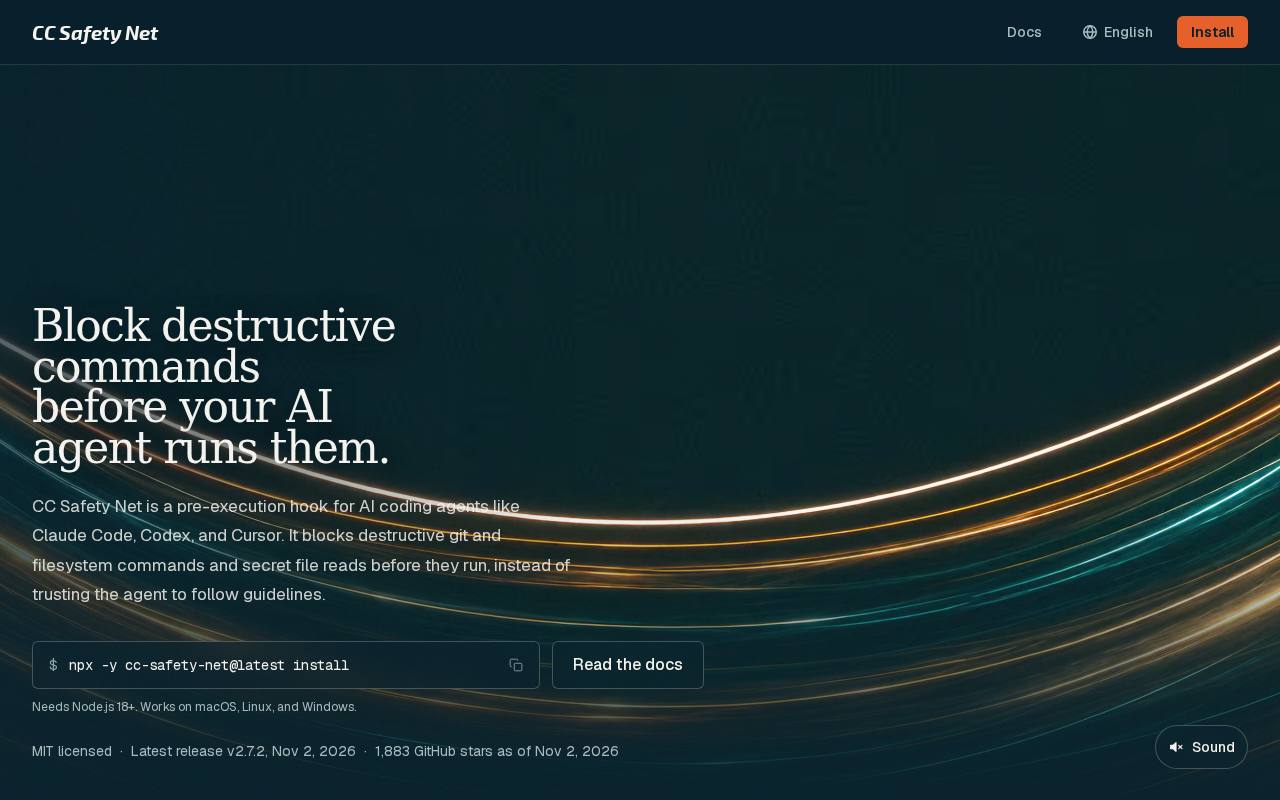
- O CC Safety Net (4,0) recusa force-pushes, hard resets, rm -rf em alvos perigosos e leituras das suas chaves, e não se deixa enganar quando o comando é embrulhado em
bash -c. Ele cobre a brecha que o sandbox deixa aberta. - O security-guidance (4,2), plugin da Anthropic para o Claude Code, revisa cada edição, turno e commit com uma nova chamada ao modelo. Ele aconselha e nunca bloqueia, então trate-o como um aviso antecipado e não como uma tranca.
3. Revisar: deixe o agente caçar bugs
É aqui que os agentes são realmente bons, desde que nada dependa de eles pegarem tudo.
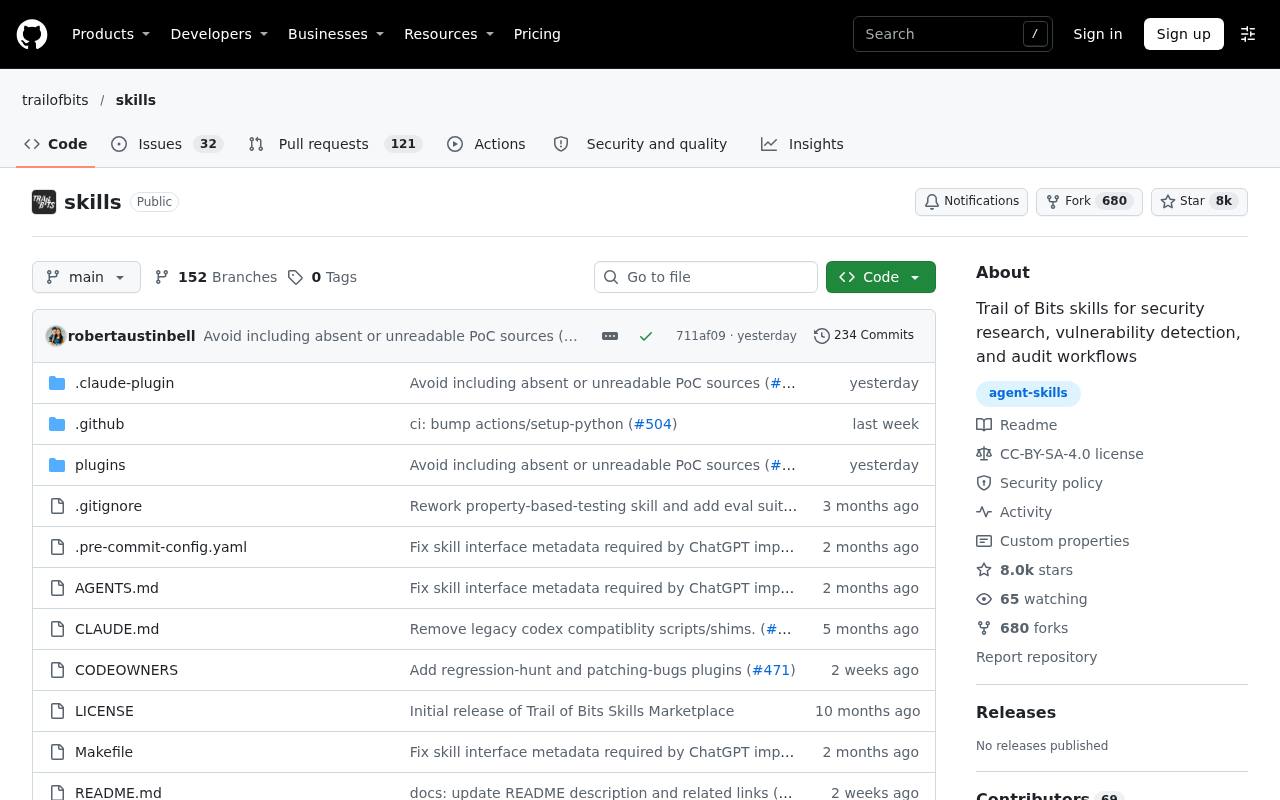
- O Trail of Bits Skills (4,4) empacota os métodos de auditoria de uma empresa de segurança; as melhores skills comandam o CodeQL e o Semgrep em vez de confiar no julgamento do modelo.
- O Cloudflare Security Audit Skill (3,9) faz um segundo agente tentar refutar cada achado. A Cloudflare diz que uma execução encontra cerca de metade do que execuções repetidas encontram, então rode-o mais de uma vez.
4. Verificar: confira o que você instala
Toda skill, plugin e servidor MCP é código e instrução em que o seu agente vai confiar. Isso faz deles uma cadeia de suprimentos.
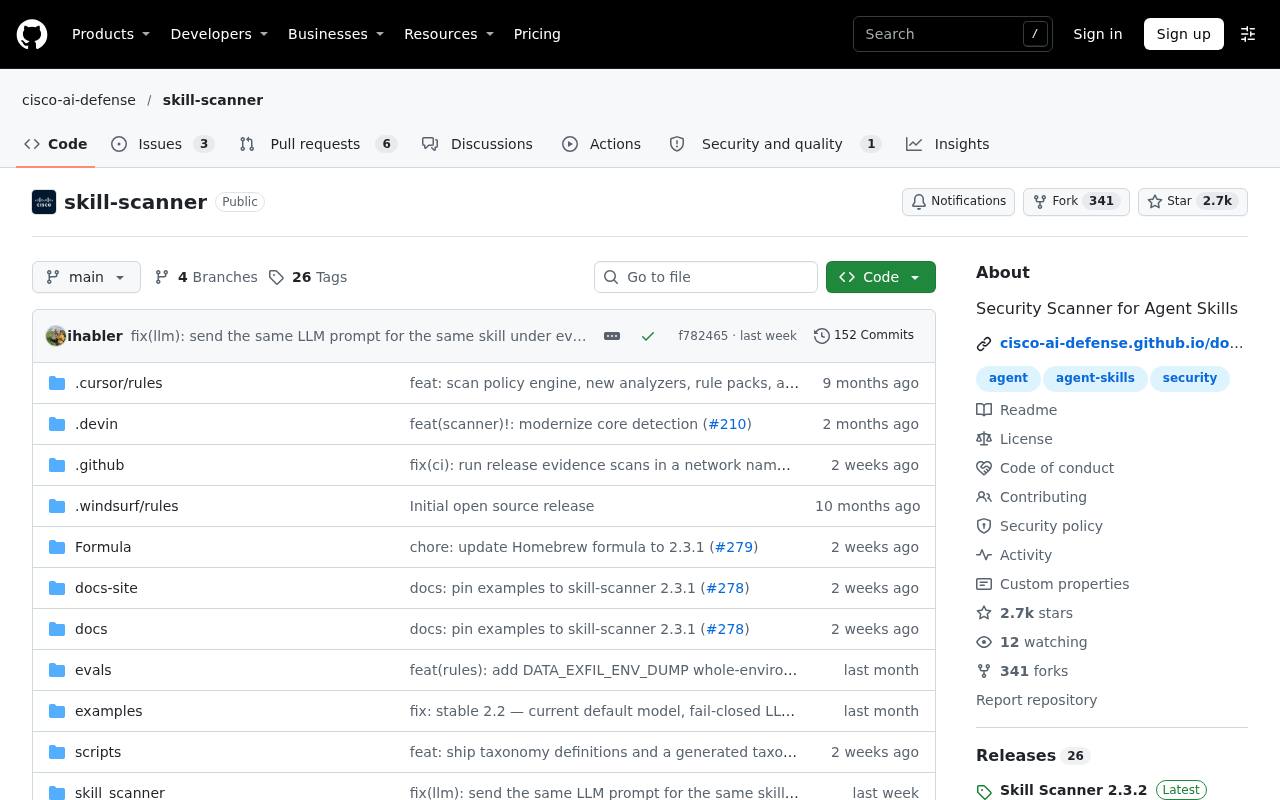
- O Cisco Skill Scanner (3,7) verifica skills antes que o seu agente as leia e publica suas próprias taxas de detecção, que são modestas.
- O Snyk Agent Scan (3,8) encontra todos os servidores MCP e skills já instalados em uma máquina. Ele envia as descrições das ferramentas ao Snyk para análise.
- O ToolHive (4,1) roda cada servidor MCP em seu próprio contêiner restrito, para que um servidor malicioso consiga fazer menos.
5. Barrar: a verificação que o agente não consegue tocar
Código escrito por IA deve passar pela mesma barreira de merge que código humano. Um modelo pode ser convencido a abandonar um achado; um job de CI que falhou, não.
- O Semgrep (4,3) como verificação de status obrigatória, com seu servidor MCP ou o plugin Guardian para que o agente veja as mesmas regras enquanto trabalha.
- No plano grátis do Semgrep, acrescente o OSV-Scanner para dependências vulneráveis e o Gitleaks para segredos vazados. Os dois são grátis e de código aberto.
Se você adotar só três
Ative o sandbox embutido, instale o plugin security-guidance e torne o Semgrep uma verificação obrigatória na CI. Isso dá uma coisa que impõe, uma que avisa cedo e uma barreira que o agente não consegue pular.
O porém: ferramentas de segurança também são ferramentas. Hooks rodam com as suas permissões toda vez que o agente age, scanners enviam dados a fornecedores e instaladores puxam @latest. Um hook de "segurança" malicioso é mais perigoso que uma skill maliciosa, porque a função dele faz as pessoas confiarem nele. Fixe versões, prefira o repositório do próprio fornecedor aos forks e teste hooks novos primeiro dentro de um sandbox.
O que nenhuma delas resolve
- Prompt injection. Nada o detecta de forma confiável. A contenção vem primeiro porque o melhor que se pode fazer é limitar o estrago.
- Vazamentos para hosts permitidos. Uma allowlist decide onde o agente pode se conectar, não o que ele envia. Se o GitHub é permitido, um gist público é permitido. Plante uma chave falsa em um repositório descartável e faça a CI falhar se ela aparecer no tráfego de saída.
- Lógica de autorização. Se o cliente A pode ler os dados do cliente B é uma pergunta que scanners raramente respondem e que revisores de IA respondem de forma inconsistente. Mantenha uma pessoa no código de autenticação.
- Aprovações automáticas. Alguém clicando em aprovar dezenas de mudanças de agentes por dia não é um controle. Mande só as arriscadas para pessoas, e dê tempo a elas.
Nossa opinião: encontrar problemas pode ficar dentro do agente. Impedir ações perigosas precisa ficar fora dele, e aprovar código para produção deve ficar totalmente fora da sessão de programação. Instale o sandbox antes da skill de segurança.