
코딩 에이전트 보안: 다섯 개의 층, 그리고 실제로 무언가를 막는 도구
작성자 Sheela ·
코딩 에이전트는 사용자를 대신해 파일을 읽고, 명령을 실행하고, 무언가를 설치합니다. 에이전트용으로 인기 있는 "AI 보안" 도구 대부분은 조언만 합니다. 실제로 무언가를 막는 도구를 어떻게 쌓을지, 그리고 조언하는 도구는 어디에 들어가는지 정리합니다.
원리는 간단합니다. 에이전트 안에서 돌아가는 것은 무엇이든 설득당할 수 있습니다. 프롬프트 인젝션이 모델을 말로 구슬릴 수 있기 때문입니다. 그래서 반드시 지켜져야 하는 결정은 에이전트 바깥, 즉 운영체제, 훅, CI에 둡니다. 아래의 별 개수는 2026년 10월 24일 GitHub에서 확인한 것이며, 어떤 도구가 실제로 무언가를 강제하는지에 대해서는 거의 말해 주지 않습니다. Cloudflare의 감사 스킬은 커밋 14개로 여기 있는 모든 차단 도구를 합친 것보다 별이 많습니다.
1. 격리: 에이전트가 닿을 수 있는 범위를 정한다
다른 모든 것이 실패해도 샌드박스는 에이전트가 읽거나 쓸 수 있는 파일과 연결할 수 있는 호스트를 여전히 정합니다.
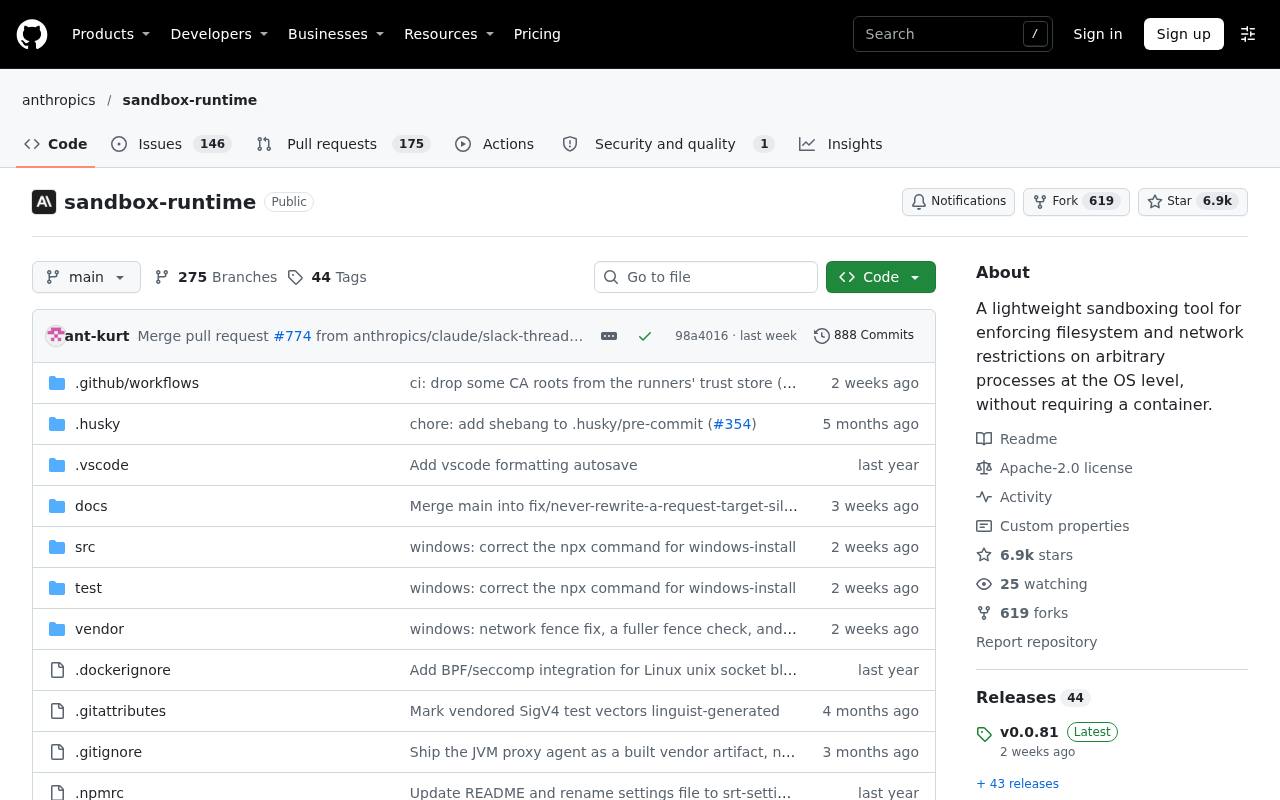
- Anthropic Sandbox Runtime(4.4)은 Claude Code의
/sandbox뒤에 있는 엔진입니다. 운영체제 자체의 샌드박스를 쓰고, 컨테이너가 필요 없으며, 무료입니다. 의도적으로 프로젝트 안의 쓰기를 허용하므로 hard reset은 막지 못합니다. - NVIDIA OpenShell(4.1)은 더 무겁습니다. 에이전트마다 샌드박스를 두고, 에이전트가 절대 보지 못하는 자격 증명을 쓰며, 정책 변경은 적용 전에 검사합니다. 무인으로 계속 돌려 두는 에이전트에 맞습니다.
작업마다 하나를 고르십시오. 같은 에이전트에 둘 다 돌리면 디버그할 규칙 세트만 두 개가 됩니다.
2. 가드: 위험한 동작을 실행 전에 막는다
- CC Safety Net(4.0)은 force push, hard reset, 위험한 대상에 대한 rm -rf, 키 읽기를 거부하며, 명령을
bash -c로 감싸도 속지 않습니다. 샌드박스가 열어 두는 틈을 메웁니다. - Anthropic의 Claude Code 플러그인인 security-guidance(4.2)는 모든 편집, 턴, 커밋을 새로운 모델 호출로 검토합니다. 조언만 하고 절대 차단하지 않으므로 잠금장치가 아니라 조기 경보로 여기십시오.
3. 리뷰: 에이전트가 버그를 찾게 한다
여기는 에이전트가 정말로 잘하는 영역입니다. 에이전트가 모든 것을 잡아내는 데 아무것도 의존하지 않는다면 말입니다.
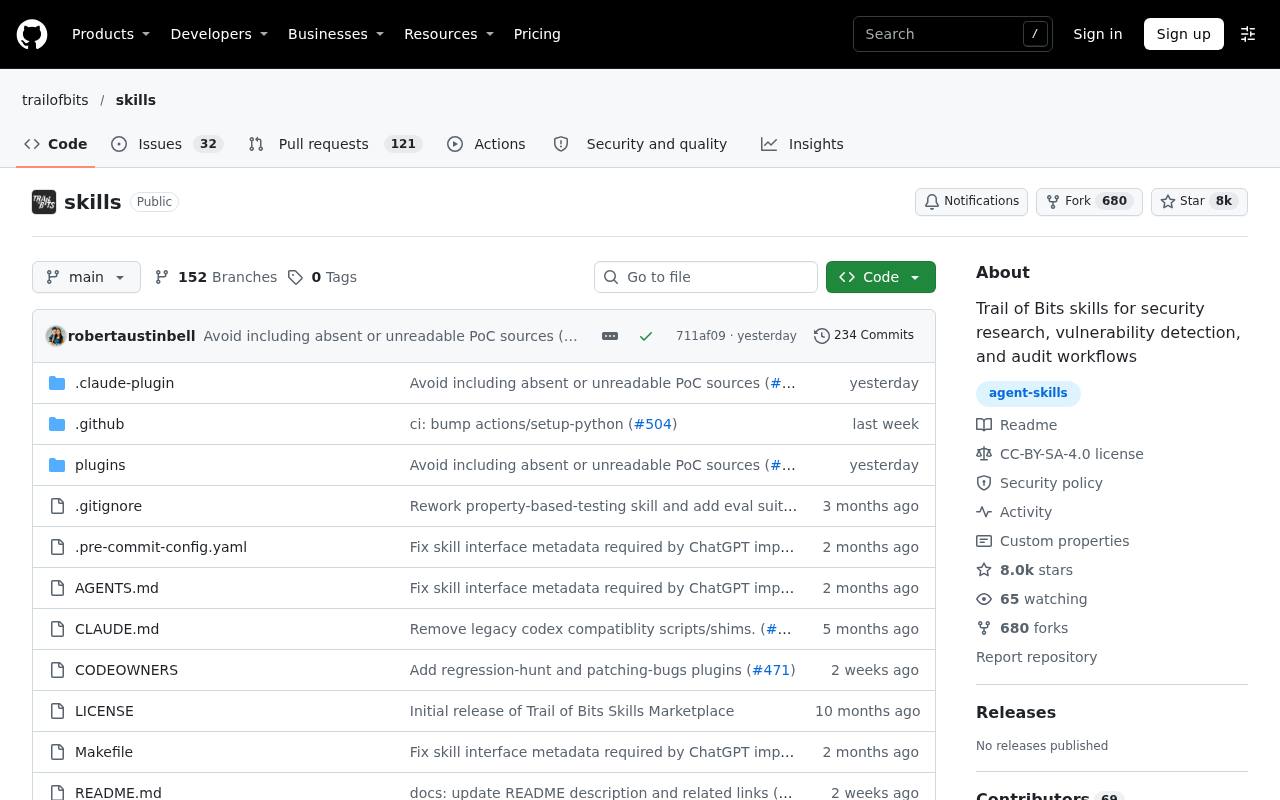
- Trail of Bits Skills(4.4)는 보안 회사의 감사 방법을 묶은 것입니다. 가장 좋은 스킬은 모델의 판단을 믿는 대신 CodeQL과 Semgrep을 구동합니다.
- Cloudflare Security Audit Skill(3.9)은 두 번째 에이전트가 모든 발견 사항을 반박하려 시도하게 합니다. Cloudflare는 한 번 실행하면 반복 실행으로 찾는 것의 약 절반을 찾는다고 말하니, 두 번 이상 돌리십시오.
4. 검증: 설치하는 것을 확인한다
모든 스킬, 플러그인, MCP 서버는 에이전트가 신뢰하게 될 코드와 지침입니다. 그래서 이들은 공급망입니다.
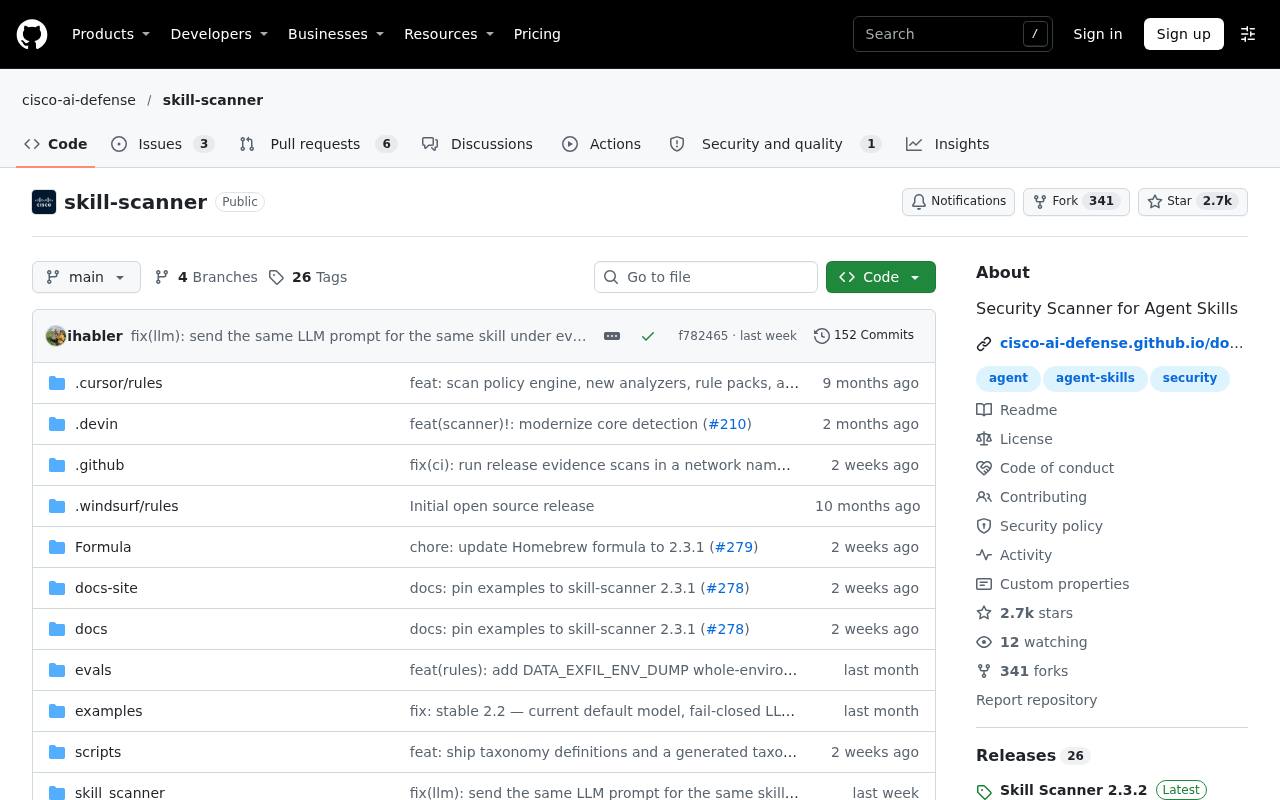
- Cisco Skill Scanner(3.7)는 에이전트가 스킬을 읽기 전에 스캔하며, 자체 탐지율을 공개하는데 그 수치는 수수합니다.
- Snyk Agent Scan(3.8)은 머신에 이미 설치된 모든 MCP 서버와 스킬을 찾습니다. 분석을 위해 도구 설명을 Snyk로 보냅니다.
- ToolHive(4.1)는 각 MCP 서버를 잠긴 자체 컨테이너에서 돌려, 나쁜 서버가 할 수 있는 일을 줄입니다.
5. 관문: 에이전트가 건드릴 수 없는 검사
AI가 쓴 코드도 사람이 쓴 코드와 같은 병합 관문을 거쳐야 합니다. 모델은 발견 사항을 말로 넘어가도록 설득당할 수 있지만, 실패한 CI 작업은 그럴 수 없습니다.
- Semgrep(4.3)을 필수 상태 검사로 두고, MCP 서버나 Guardian 플러그인을 함께 써서 에이전트가 작업하는 동안 같은 규칙을 보게 하십시오.
- Semgrep 무료 등급이라면 취약한 의존성용 OSV-Scanner와 유출된 비밀용 Gitleaks를 더하십시오. 둘 다 무료 오픈소스입니다.
셋만 도입한다면
내장 샌드박스를 켜고, security-guidance 플러그인을 설치하고, Semgrep을 필수 CI 검사로 만드십시오. 강제하는 것 하나, 일찍 경고하는 것 하나, 에이전트가 건너뛸 수 없는 관문 하나입니다.
주의할 점: 보안 도구도 도구입니다. 훅은 에이전트가 행동할 때마다 사용자의 권한으로 실행되고, 스캐너는 업체로 데이터를 보내며, 설치 프로그램은 @latest를 받아옵니다. 악성 "보안" 훅은 악성 스킬보다 더 위험합니다. 그 역할 때문에 사람들이 믿기 때문입니다. 버전을 고정하고, 포크보다 업체 자체 저장소를 우선하고, 새 훅은 먼저 샌드박스 안에서 시험하십시오.
어느 것도 해결하지 못하는 것
- 프롬프트 인젝션. 이를 확실하게 탐지하는 것은 없습니다. 할 수 있는 최선이 피해를 제한하는 것이라서 격리가 먼저입니다.
- 허용된 호스트로의 유출. 허용 목록은 에이전트가 어디에 연결할 수 있는지를 정할 뿐, 무엇을 보내는지는 정하지 않습니다. GitHub가 허용되면 공개 gist도 허용됩니다. 쓰고 버릴 저장소에 가짜 키를 심어 두고, 그것이 나가는 트래픽에 나타나면 CI를 실패시키십시오.
- 권한 부여 로직. 고객 A가 고객 B의 데이터를 읽을 수 있는가는 스캐너가 거의 답하지 못하고 AI 리뷰어는 일관되지 않게 답하는 질문입니다. 인증 코드에는 사람을 두십시오.
- 형식적인 승인. 하루에 수십 건의 에이전트 변경을 승인 클릭으로 넘기는 것은 통제가 아닙니다. 위험한 것만 사람에게 보내고, 시간을 주십시오.
결론: 문제를 찾는 일은 에이전트 안에 있어도 됩니다. 위험한 동작을 막는 일은 바깥에 있어야 하고, 운영용 코드를 승인하는 일은 아예 코딩 세션 바깥에 속합니다. 보안 스킬보다 샌드박스를 먼저 설치하십시오.