
Analysen Agenten-Frameworks und Automatisierung
Entscheidungsmodelle erklärt: Jev, Laya und der Aufstieg der System-One-KI
Von Sheela ·
Ein Entscheidungsmodell schreibt nicht. Du gibst ihm ein Stück Text oder JSON und ein paar typisierte Fragen, und es liefert eine Auswahl, eine Bewertung oder eine Ja/Nein-Wahrscheinlichkeit zurück, mit den Wahrscheinlichkeiten hinter jeder Antwort. Diese enge Aufgabe macht es schneller und weit günstiger, als ein Chatmodell zu fragen, und es ist das richtige Werkzeug für einen überraschend großen Teil dessen, was Agenten den ganzen Tag tun: Routing, Triage, Schutzprüfungen und Freigaben. Ein Werkzeug, dem man ohne Test mit den eigenen Daten vertrauen kann, ist es noch nicht.
Was ein „System One“-Modell ist
Der Begriff stammt von TypeSafe, einem Labor in San Francisco, das Jev sein erstes „System One model“ nennt, gebaut für Entscheidungen innerhalb von Software statt für Gespräche. Laut der Dokumentation von TypeSafe hat jede Anfrage einen state (die Belege) und eine Reihe von Fragen dreier Typen: choice wählt eine Option aus einer Liste, score bewertet den State auf einer geordneten Skala, und noul liefert die Wahrscheinlichkeit, dass eine Aussage wahr ist. Zum selben State lassen sich in einem Aufruf mehrere Fragen stellen, und die Antwort kommt als typisierte Werte zurück, die dein Code mit einem Schwellenwert vergleichen kann. Es gibt keinen Fließtext zu parsen.
Wie sie sich von LLMs und Klassifikatoren unterscheiden
Gegenüber einem Chatmodell liegt der Unterschied in der Ausgabe. Ein LLM, das gefragt wird „Ist dieses Ticket dringend?“, liefert einen Satz, den der Agent deuten muss, und kein verlässliches Signal dafür, wie sicher es ist. Ein Entscheidungsmodell liefert eine Zahl pro Option. Laya und GLiNER2.5-Decide antworten beide in einem einzigen Forward Pass, ohne Tokens zu generieren.
Gegenüber einem klassischen Klassifikator liegt der Unterschied darin, dass die Labels nicht fest eingebaut sind. Ein trainiertes Sentiment- oder Intent-Modell kennt nur die Klassen, auf die es trainiert wurde. Ein Entscheidungsmodell liest die Optionen aus der Anfrage, sodass du Kategorien ohne Neutraining hinzufügen oder umbenennen kannst; so beschreibt die Model Card von Fastino GLiNER2.5-Decide. In der Praxis ist die Grenze unscharf: GLiNER2.5-Decide ist ein Encoder, ganz ähnlich einem Klassifikator, und die Maintainer von Laya sagen, es brauche Fine-Tuning auf deinen eigenen Entscheidungen, um genau zu sein.
Wo sie in einen Agenten passen
- Routing. Welchem Team ein Ticket gehört, welches Modell eine Aufgabe übernehmen soll, welches Tool aufzurufen ist. Eine choice-Frage mit Konfidenzschwelle lässt den Agenten in klaren Fällen handeln und den Rest eskalieren.
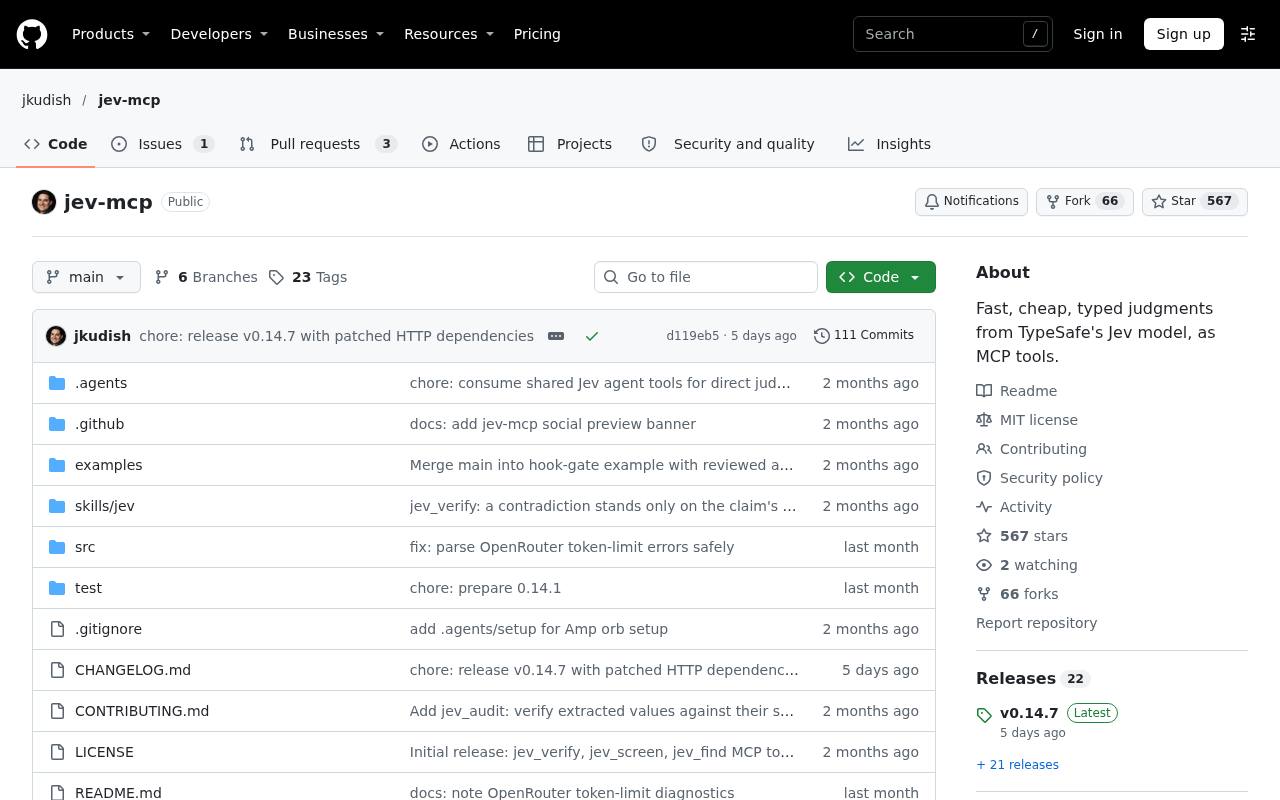
- Schutzprüfungen. Eine abgerufene Seite oder ein Tool-Ergebnis auf Prompt Injection prüfen, bevor es das Hauptmodell erreicht. Jev MCP und Viorants gehostetes Jev liefern beide genau dafür ein Tool
jev_screen. - Freigabe von Tool-Aufrufen. Eine vorgeschlagene Aktion, einen Diff oder eine Erledigt-Meldung bewerten, bevor sie ausgeführt wird oder bevor der Agent die Aufgabe für abgeschlossen erklärt.
jev_reviewundjev_gatevon Jev MCP tun das für Coding-Agenten. - Triage und Verifikation. Einen Backlog labeln, Suchergebnisse neu ordnen oder jede Behauptung in einem Bericht mit ihren Quellen abgleichen, in Mengen, die durch ein Frontier-Modell zu langsam und zu teuer wären.
Was sie nicht tun sollten: offene Fragen beantworten, sich selbst erklären oder planen. Fastinos eigene Model Card sagt, GLiNER2.5-Decide „does not reason, explain, or answer open questions“.
Die wichtigsten Optionen
- Jev (TypeSafe). Nur gehostet; wir haben keine Aussage gefunden, dass die Gewichte veröffentlicht werden. TypeSafe nennt 42 $ pro Milliarde Input-Tokens. Laut README von jev-mcp wird es auch über OpenRouter und Cloudflare Workers AI verkauft. Laut Launch-Beitrag von TypeSafe verarbeitet es bis zu 255 Optionen pro choice-Frage.
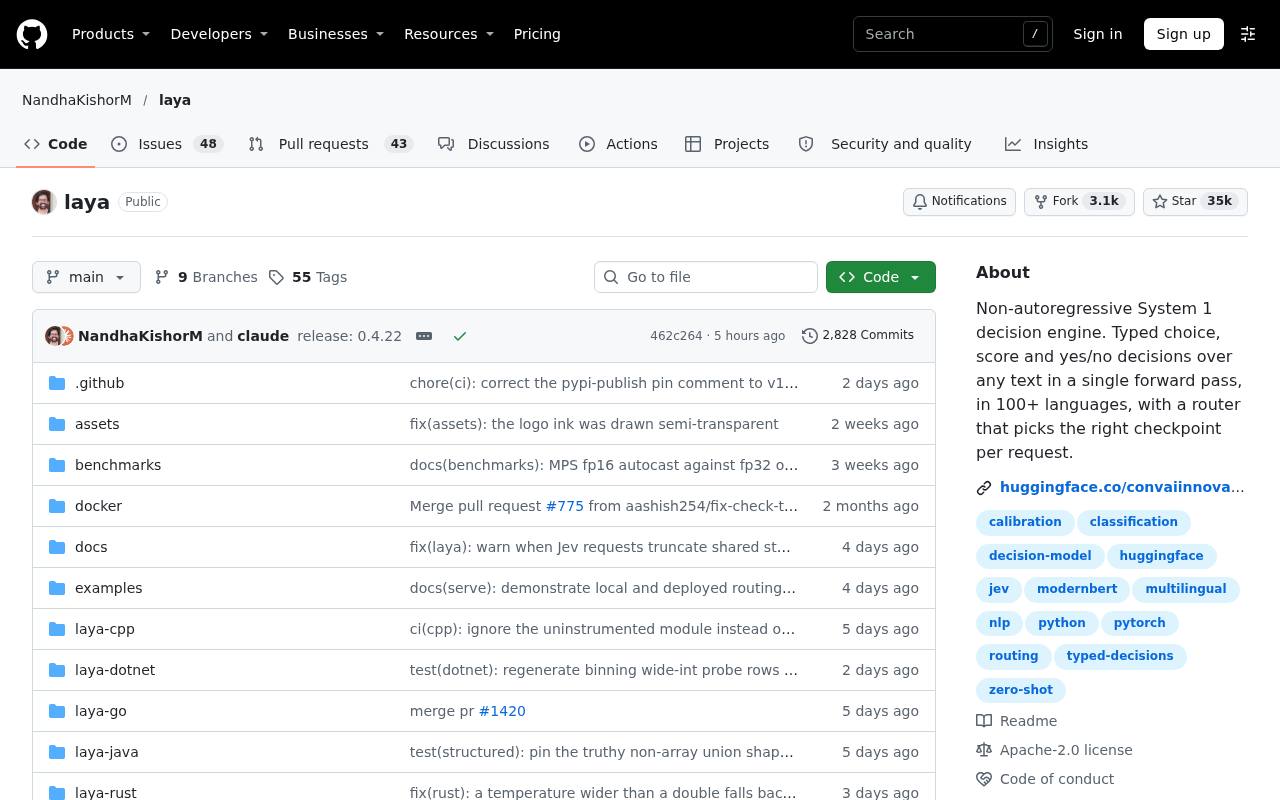
- Laya (Convai Innovations). Offene Gewichte unter Apache 2.0, drei Checkpoints mit 322M bis 421M Parametern und ein Router, der nicht englischen Text an einen mehrsprachigen Checkpoint für 100+ Sprachen schickt. Sein README meldet 32,8 ms für eine Frage auf einer T4-GPU.
- Clef und Clef-flash (Cloudflare). Am 1. Oktober 2026 mit Gewichten unter Apache 2.0 veröffentlicht, mit 27B und 9B Parametern und einem Kontext von 64K Tokens, auf Workers AI und Hugging Face. Sie folgen derselben System-One-API wie Jev; laut Cloudflare heißt ein Wechsel also, Endpoint und Modellnamen zu ändern.
- GLiNER2.5-Decide (Fastino). Ein kleiner englischer Encoder (Fastino nennt 340M Parameter; die Gewichtsdatei enthält etwa 486M) unter Apache 2.0, der auf der CPU läuft, mit einer mehrsprachigen Variante; die Model Card führt ihn als Fine-Tune von GLiNER2.
- Perplexity Decider (pplx-decider) (Perplexity). Perplexitys offene Entscheidungsmodelle mit 27B und 4B, auch als API für 0,02 $ pro Million Tokens verkauft: Text und Bilder rein, Wahrscheinlichkeiten raus.
- d3 (vLLM Semantic Router) (vLLM Semantic Router). Das offene 27B-Entscheidungsmodell des Projekts vLLM Semantic Router, Zweiter im Decision Index, mit Videoeingabe und nativem Serving über vLLM.
Das gehostete Modell macht am wenigsten Arbeit, die offenen Modelle sind am privatesten. Clef ist auf dem Papier der stärkste offene Herausforderer; Laya und GLiNER2.5-Decide sind klein genug für einen Laptop.
Eines mit deinem Agenten verbinden
Für die meisten zählt der MCP-Server genauso viel wie das Modell.
- Jev MCP (4,3) ist die Wahl für Coding-Agenten: zwölf fertige Prüfungen, darunter Injection-Screening, Verifikation von Behauptungen und Diff-Review.
- Der offizielle MCP-Server von Laya (4,2) führt alles lokal aus, mit Tools für Stapel, lange Dokumente und Shortlists.
- System One Connector (4,1) ist ein einzelnes, schlankes Tool, das mit Jev, einem selbst gehosteten Laya oder CLM oder mit d1 von Liquid AI sprechen kann.
- Jev auf Viorant (3,8) ist ein gehosteter OAuth-Endpoint mit kostenlosen Startguthaben und ohne TypeSafe-Key.
- Der Jev-Connector von AnythingMCP (3,7) passt zu Teams, die einen gemeinsamen, auditierten Key für Nutzer von claude.ai und ChatGPT wollen.
Die ehrlichen Grenzen
Fast jeder Benchmark ist ein Herstellerbenchmark. Cloudflares Changelog sieht Clef bei 7 von 10 Entscheidungsbenchmarks vor Jev, darunter 94,20 gegen 79,74 bei BANKING77, und Clef-flash mit einem Median von 38,8 ms gegen 524,1 ms bei Jev. Fastinos Model Card setzt GLiNER2.5-Decide auf Fastinos eigenem Datensatz auf Platz eins, mit Layas Router auf dem letzten Platz. Layas README setzt Laya bei den meisten Aufgaben vor Jev, mit Jev-Werten, die es nach eigener Aussage nie selbst gemessen hat. Die Zahlen widersprechen sich, weil jeder Hersteller den Test ausgesucht hat.
Die Zero-Shot-Genauigkeit kann schlecht sein. Die Maintainer von Laya schreiben, dass seine Basis-Checkpoints auf ihrem eigenen Benchmark für typisierte Entscheidungen „near chance“ liegen (0,362 gegenüber einer Zufallsbasis von 0,318) und dass der Spitzenwert von 0,766 von einem Checkpoint stammt, der auf dem Trainingssplit dieses Benchmarks feinjustiert wurde. Sie dokumentieren außerdem verneinte Kündigungsanfragen, die mit einer Wahrscheinlichkeit von 0,9998 als Kündigungen eingestuft wurden, und eine Genauigkeit, die bei einer Aufgabe mit 77 Labels auf 0,425 fällt.
Konfidenz ist nicht Korrektheit. Eine kalibrierte Wahrscheinlichkeit ist das Verkaufsargument, aber Layas README hält fest, dass seine Checkpoints im Auslieferungszustand übermäßig selbstsicher sind und dass Konfidenz „orders decisions; it does not establish that a decision is correct“. Lege Schwellenwerte anhand deiner eigenen gelabelten Daten fest.
Alles ist neu. Das Repository von Laya wurde am 18. September 2026 angelegt; Clef erschien am 1. Oktober; die hier besprochenen Jev-MCP-Server sind alle jünger als fünf Wochen. Versionsnummern ändern sich wöchentlich, und der Autor von jev-mcp nennt es frühe Software.
Wer eines nutzen sollte
Nutze ein Entscheidungsmodell, wenn dein Agent dieselbe Art begrenzter Beurteilung viele Male trifft (Tickets routen, abgerufene Inhalte prüfen, Tool-Aufrufe freigeben) und du sagen kannst, wie die richtigen Antworten aussehen. Fang mit Jev über Jev MCP an, wenn du gute Ergebnisse ohne eigenes Training willst und Daten an einen gehosteten Dienst schicken kannst. Wähle Laya oder Clef, wenn Daten auf deiner Hardware bleiben müssen, und plane Zeit ein, um Beispiele zu labeln und Schwellenwerte festzulegen.
Lass es bleiben, wenn deine Entscheidungen selten, offen oder erklärungsbedürftig sind; ein Frontier-Modell ist dann weiterhin das bessere Werkzeug. Und was du auch wählst, halte ein Frontier-Modell oder einen Menschen für die Fälle mit niedriger Konfidenz bereit. Der Gewinn kommt daher, einfache Entscheidungen schnell zu beantworten, nicht daher, ein Modell mit 400M Parametern alles entscheiden zu lassen.