
결정 모델 해설: Jev, Laya, 그리고 System One AI의 부상
작성자 Sheela ·
결정 모델은 글을 쓰지 않습니다. 텍스트나 JSON 한 조각과 타입이 정해진 질문 몇 개를 주면, 선택, 점수 또는 예/아니요 확률을 각 답 뒤의 확률과 함께 돌려줍니다. 이렇게 좁은 일을 하기 때문에 채팅 모델에 묻는 것보다 빠르고 훨씬 저렴하며, 에이전트가 하루 종일 하는 일 가운데 놀랄 만큼 많은 부분에 알맞은 도구입니다. 라우팅, 분류, 가드 검사, 게이팅입니다. 다만 아직은 자체 데이터로 테스트하지 않고 믿을 만한 도구가 아닙니다.
"System One" 모델이란
이 용어는 샌프란시스코의 연구소 TypeSafe에서 나왔습니다. TypeSafe는 Jev를 대화가 아니라 소프트웨어 내부의 결정을 위해 만든 첫 "System One 모델"이라고 부릅니다. TypeSafe 문서에 따르면 모든 요청에는 state(근거)와 세 가지 유형의 질문 집합이 있습니다. choice는 목록에서 하나를 고르고, score는 순서가 있는 기준표로 state를 평가하며, noul은 어떤 진술이 참일 확률을 돌려줍니다. 한 번의 호출로 같은 state에 여러 질문을 할 수 있고, 답은 코드가 임계값과 비교할 수 있는 타입화된 값으로 돌아옵니다. 파싱할 문장은 없습니다.
LLM 및 분류기와 다른 점
채팅 모델과 비교하면 차이는 출력입니다. "이 티켓은 긴급한가?"라고 물으면 LLM은 에이전트가 해석해야 하는 문장을 돌려주며, 얼마나 확신하는지에 대한 신뢰할 만한 신호는 주지 않습니다. 결정 모델은 선택지마다 숫자를 돌려줍니다. Laya와 GLiNER2.5-Decide는 둘 다 토큰을 하나도 생성하지 않고 단 한 번의 순전파로 답합니다.
고전적인 분류기와 비교하면 차이는 레이블이 고정되어 있지 않다는 점입니다. 학습된 감성 모델이나 의도 모델은 학습한 클래스만 압니다. 결정 모델은 요청에서 선택지를 읽으므로 재학습 없이 범주를 추가하거나 이름을 바꿀 수 있으며, Fastino의 모델 카드도 GLiNER2.5-Decide를 이렇게 설명합니다. 실제로는 경계가 흐릿합니다. GLiNER2.5-Decide는 분류기와 매우 비슷한 인코더이고, Laya의 관리자들은 정확도를 내려면 자체 결정 데이터로 파인튜닝해야 한다고 말합니다.
에이전트의 어디에 맞나
- 라우팅. 어느 팀이 티켓을 맡을지, 어떤 모델이 작업을 처리할지, 어떤 도구를 호출할지. 신뢰도 기준선이 있는 choice 질문을 쓰면 에이전트는 분명한 경우에는 바로 행동하고 나머지는 상위로 넘깁니다.
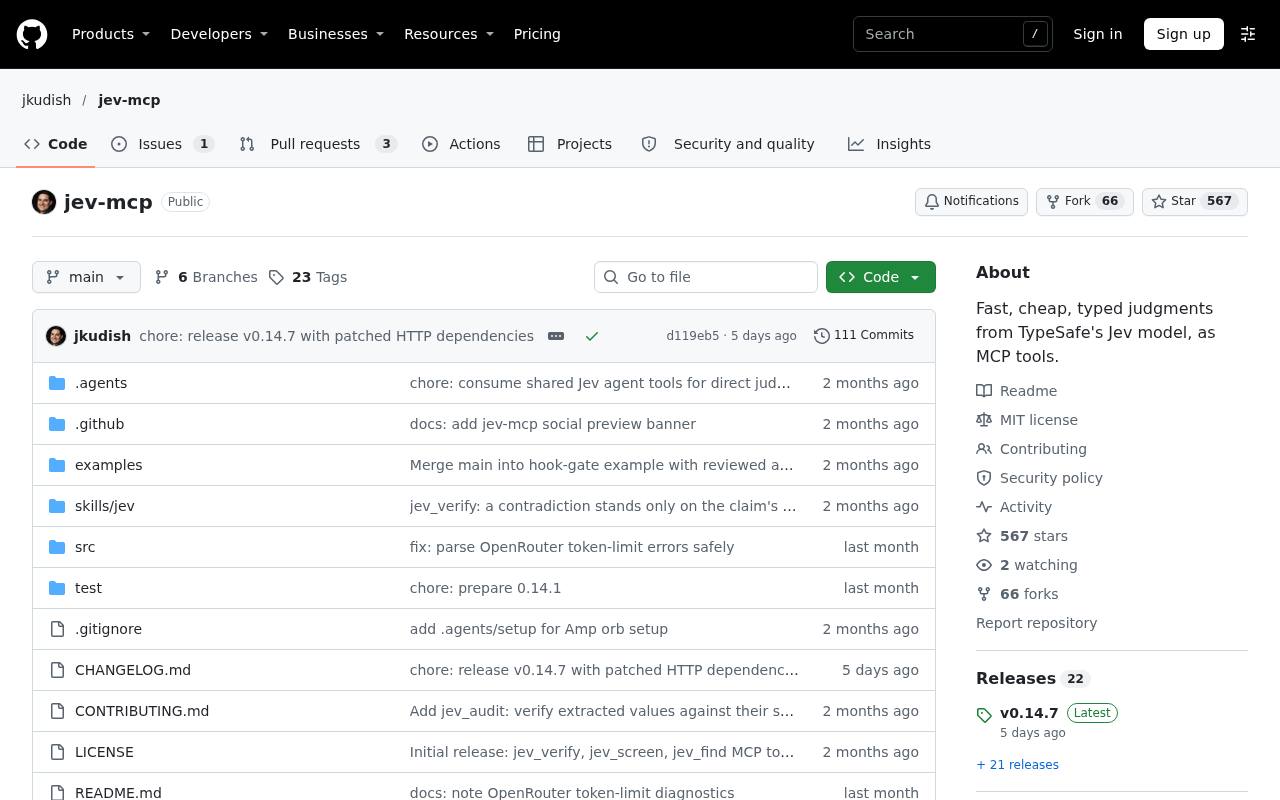
- 가드. 가져온 페이지나 도구 결과가 메인 모델에 닿기 전에 프롬프트 인젝션을 걸러 냅니다. Jev MCP와 Viorant의 호스팅형 Jev는 모두 바로 이 용도의
jev_screen도구를 제공합니다. - 도구 호출 게이팅. 제안된 동작, diff 또는 완료 주장이 실행되기 전, 혹은 에이전트가 작업 완료를 선언하기 전에 점수를 매깁니다. Jev MCP의
jev_review와jev_gate가 코딩 에이전트를 위해 이 일을 합니다. - 분류와 검증. 백로그에 레이블 붙이기, 검색 결과 재정렬, 보고서의 각 주장을 출처와 대조하기 등을, 프런티어 모델로 돌리기에는 너무 느리고 비싼 규모의 배치로 처리합니다.
하지 말아야 할 일은 열린 질문에 답하기, 스스로를 설명하기, 계획하기입니다. Fastino의 모델 카드도 GLiNER2.5-Decide가 "추론하거나, 설명하거나, 열린 질문에 답하지 않는다"고 밝힙니다.
주요 선택지
- Jev(TypeSafe). 호스팅 전용이며, 가중치를 공개한다는 언급은 찾지 못했습니다. TypeSafe는 입력 토큰 10억 개당 $42를 제시합니다. jev-mcp README에 따르면 OpenRouter와 Cloudflare Workers AI를 통해서도 판매됩니다. TypeSafe의 출시 글에 따르면 choice 질문 하나에 선택지를 최대 255개까지 다룹니다.
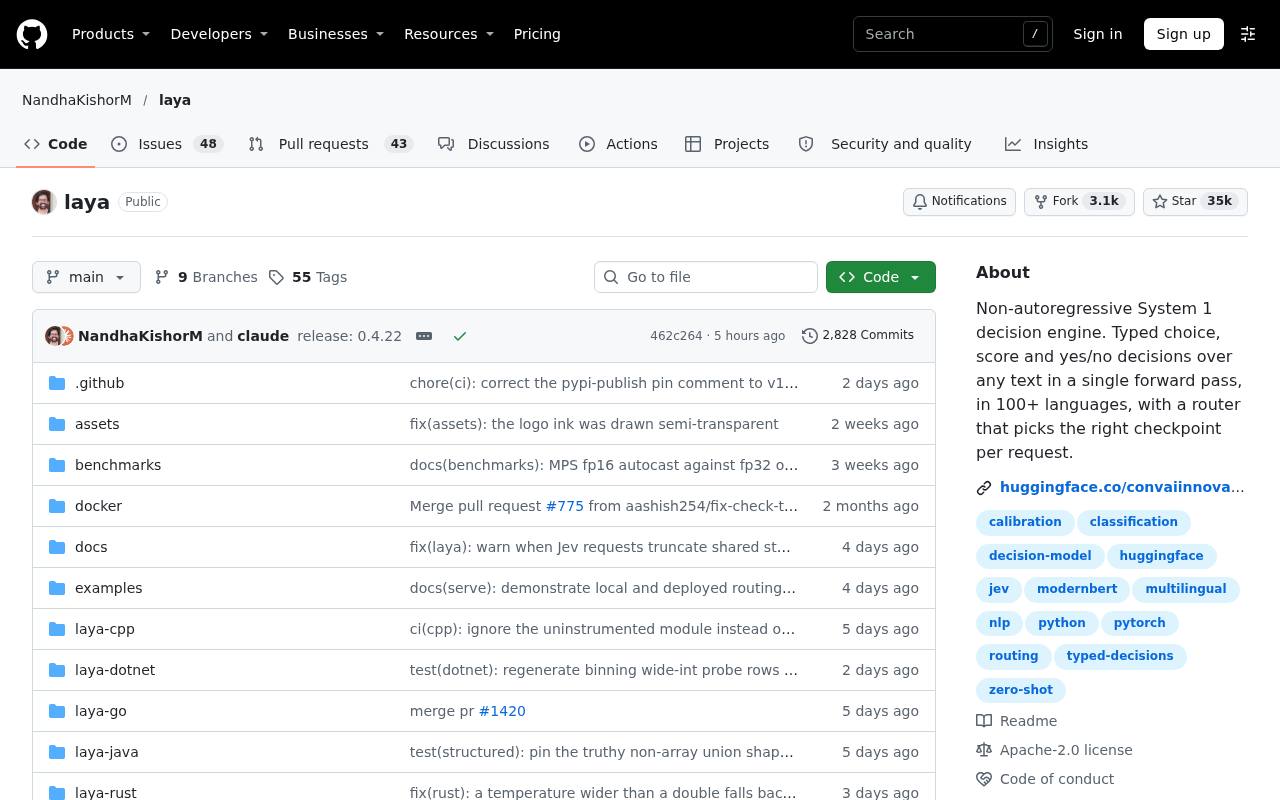
- Laya(Convai Innovations). Apache 2.0 오픈 웨이트, 322M에서 421M 파라미터의 체크포인트 세 개, 그리고 영어가 아닌 텍스트를 100개 이상의 언어를 지원하는 다국어 체크포인트로 보내는 라우터가 있습니다. README는 T4 GPU에서 질문 하나에 32.8 ms를 보고합니다.
- Clef와 Clef-flash(Cloudflare). 2026년 10월 1일 Apache 2.0 가중치로 공개되었으며, 27B와 9B 파라미터에 64K 토큰 컨텍스트를 갖추고 Workers AI와 Hugging Face에서 제공됩니다. Jev와 같은 System One API를 따르므로, Cloudflare는 엔드포인트와 모델 이름만 바꾸면 전환할 수 있다고 말합니다.
- GLiNER2.5-Decide(Fastino). Apache 2.0의 작은 영어 인코더로(Fastino는 340M 파라미터라고 하지만 가중치 파일에는 약 486M이 들어 있습니다) CPU에서 실행되며, 다국어 변형도 있습니다. 카드에는 GLiNER2에서 파인튜닝했다고 나와 있습니다.
- Perplexity Decider(pplx-decider)(Perplexity). Perplexity의 27B 및 4B 오픈 결정 모델로, 토큰 100만 개당 $0.02의 API로도 판매됩니다. 텍스트와 이미지를 넣으면 확률이 나옵니다.
- d3(vLLM Semantic Router)(vLLM Semantic Router). vLLM Semantic Router 프로젝트의 27B 오픈 결정 모델로, Decision Index 2위이며 영상 입력과 네이티브 vLLM 서빙을 지원합니다.
호스팅 모델이 가장 손이 덜 가고, 오픈 모델이 가장 사적입니다. 서류상으로는 Clef가 가장 강력한 오픈 도전자이며, Laya와 GLiNER2.5-Decide는 노트북에서 돌릴 만큼 작습니다.
에이전트에 연결하기
대부분의 사람에게는 MCP 서버가 모델만큼 중요합니다.
- Jev MCP(4.3)는 코딩 에이전트에 맞는 선택입니다. 인젝션 검사, 주장 검증, diff 리뷰를 포함해 바로 쓸 수 있는 검사 12개를 제공합니다.
- Laya 공식 MCP 서버(4.2)는 배치, 긴 문서, 후보 압축 도구와 함께 모든 것을 로컬에서 실행합니다.
- System One Connector(4.1)는 Jev, 자체 호스팅한 Laya나 CLM, 또는 Liquid AI의 d1과 통신할 수 있는 가벼운 도구 하나입니다.
- Viorant의 Jev(3.8)는 무료 시작 크레딧이 있고 TypeSafe 키가 필요 없는 호스팅 OAuth 엔드포인트입니다.
- AnythingMCP의 Jev 커넥터(3.7)는 claude.ai와 ChatGPT 사용자를 위해 감사 기록이 남는 공유 키 하나를 원하는 팀에 맞습니다.
솔직한 한계
거의 모든 벤치마크가 벤더 벤치마크입니다. Cloudflare의 변경 이력은 결정 벤치마크 10개 중 7개에서 Clef가 Jev를 앞선다고 보고하며, BANKING77에서 94.20 대 79.74, Clef-flash의 중앙값 38.8 ms 대 Jev의 524.1 ms를 제시합니다. Fastino의 카드는 Fastino 자체 데이터셋에서 GLiNER2.5-Decide를 1위로, Laya의 라우터를 꼴찌로 놓습니다. Laya의 README는 대부분의 작업에서 Laya가 Jev를 앞선다고 하는데, 그 Jev 수치는 직접 측정한 적이 없다고 스스로 밝힙니다. 각 벤더가 테스트를 골랐기 때문에 숫자들이 서로 모순됩니다.
제로샷 정확도는 낮을 수 있습니다. Laya의 관리자들은 기본 체크포인트가 자체 타입화 결정 벤치마크에서 "우연에 가깝다"(무작위 기준 0.318에 대해 0.362)고 쓰며, 대표 수치 0.766은 그 벤치마크의 학습 분할로 파인튜닝한 체크포인트에서 나왔다고 밝힙니다. 또한 부정형 취소 요청이 0.9998의 확률로 취소로 분류된 사례와, 레이블 77개짜리 작업에서 정확도가 0.425로 떨어지는 사례도 기록합니다.
확신은 정확성이 아닙니다. 보정된 확률이 장점으로 내세워지지만, Laya의 README는 배포된 상태의 체크포인트가 과신하는 경향이 있으며 신뢰도는 "결정의 순서를 정할 뿐, 결정이 옳다는 것을 입증하지는 않는다"고 적습니다. 임계값은 자체 레이블 데이터로 맞추십시오.
모든 것이 새롭습니다. Laya 저장소는 2026년 9월 18일에 만들어졌고, Clef는 10월 1일에 출시되었으며, 여기서 리뷰한 Jev MCP 서버들은 모두 5주가 채 되지 않았습니다. 버전 번호는 매주 바뀌며, jev-mcp 작성자는 이를 초기 단계 소프트웨어라고 부릅니다.
누가 써야 하나
에이전트가 같은 종류의 범위가 정해진 판단(티켓 라우팅, 가져온 콘텐츠 검사, 도구 호출 게이팅)을 여러 번 하고, 정답이 어떤 모습인지 말할 수 있다면 결정 모델을 쓰십시오. 아무것도 학습시키지 않고 좋은 결과를 원하며 데이터를 호스팅 서비스로 보낼 수 있다면 Jev MCP를 통한 Jev로 시작하십시오. 데이터가 자체 하드웨어에 머물러야 한다면 Laya나 Clef를 고르고, 예시에 레이블을 붙이고 임계값을 맞출 시간을 확보하십시오.
결정이 드물거나, 열려 있거나, 설명이 필요하다면 건너뛰십시오. 그런 경우에는 여전히 프런티어 모델이 더 나은 도구입니다. 그리고 무엇을 고르든 신뢰도가 낮은 경우 뒤에는 프런티어 모델이나 사람을 두십시오. 이점은 쉬운 판단을 빠르게 처리하는 데서 오는 것이지, 400M 파라미터 모델에 모든 결정을 맡기는 데서 오는 것이 아닙니다.