
Analyses Frameworks d'agents et automatisation
Les modèles de décision expliqués : Jev, Laya et l'essor de l'IA « System One »
Par Sheela ·
Un modèle de décision n'écrit pas. Vous lui donnez un texte ou du JSON et quelques questions typées, et il renvoie un choix, un score ou une probabilité de oui/non, avec les probabilités derrière chaque réponse. Cette tâche étroite le rend plus rapide et bien moins cher qu'un modèle de chat, et c'est le bon outil pour une part étonnante de ce que font les agents toute la journée : le routage, le tri, les contrôles de sécurité et le filtrage. Ce n'est pas encore un outil auquel se fier sans l'avoir testé sur vos propres données.
Ce qu'est un modèle « System One »
Le terme vient de TypeSafe, un laboratoire de San Francisco qui présente Jev comme son premier « System One model », conçu pour prendre des décisions à l'intérieur de logiciels plutôt que pour converser. D'après la documentation de TypeSafe, chaque requête comporte un état (les éléments à évaluer) et un ensemble de questions de trois types : choice sélectionne une option dans une liste, score évalue l'état selon une grille ordonnée, et noul renvoie la probabilité qu'une affirmation soit vraie. Plusieurs questions peuvent porter sur le même état en un seul appel, et la réponse revient sous forme de valeurs typées que votre code peut comparer à un seuil. Il n'y a pas de prose à analyser.
En quoi ils diffèrent des LLM et des classifieurs
Face à un modèle de chat, la différence tient à la sortie. Un LLM à qui l'on demande « ce ticket est-il urgent ? » renvoie une phrase, que l'agent doit interpréter, et ne donne aucun signal fiable de son degré de certitude. Un modèle de décision renvoie un nombre par option. Laya et GLiNER2.5-Decide répondent tous deux en une seule passe avant, sans générer de tokens.
Face à un classifieur classique, la différence est que les étiquettes ne sont pas figées. Un modèle entraîné de sentiment ou d'intention ne connaît que les classes sur lesquelles il a été entraîné. Un modèle de décision lit les options dans la requête : vous pouvez donc ajouter ou renommer des catégories sans réentraînement, et c'est ainsi que la fiche du modèle de Fastino décrit GLiNER2.5-Decide. En pratique, la frontière est floue : GLiNER2.5-Decide est un encodeur très proche d'un classifieur, et les mainteneurs de Laya disent qu'il faut l'affiner sur vos propres décisions pour qu'il soit précis.
Leur place dans un agent
- Routage. Quelle équipe est responsable d'un ticket, quel modèle doit traiter une tâche, quel outil appeler. Une question de type choice avec un seuil de confiance permet à l'agent d'agir sur les cas clairs et de faire remonter les autres.
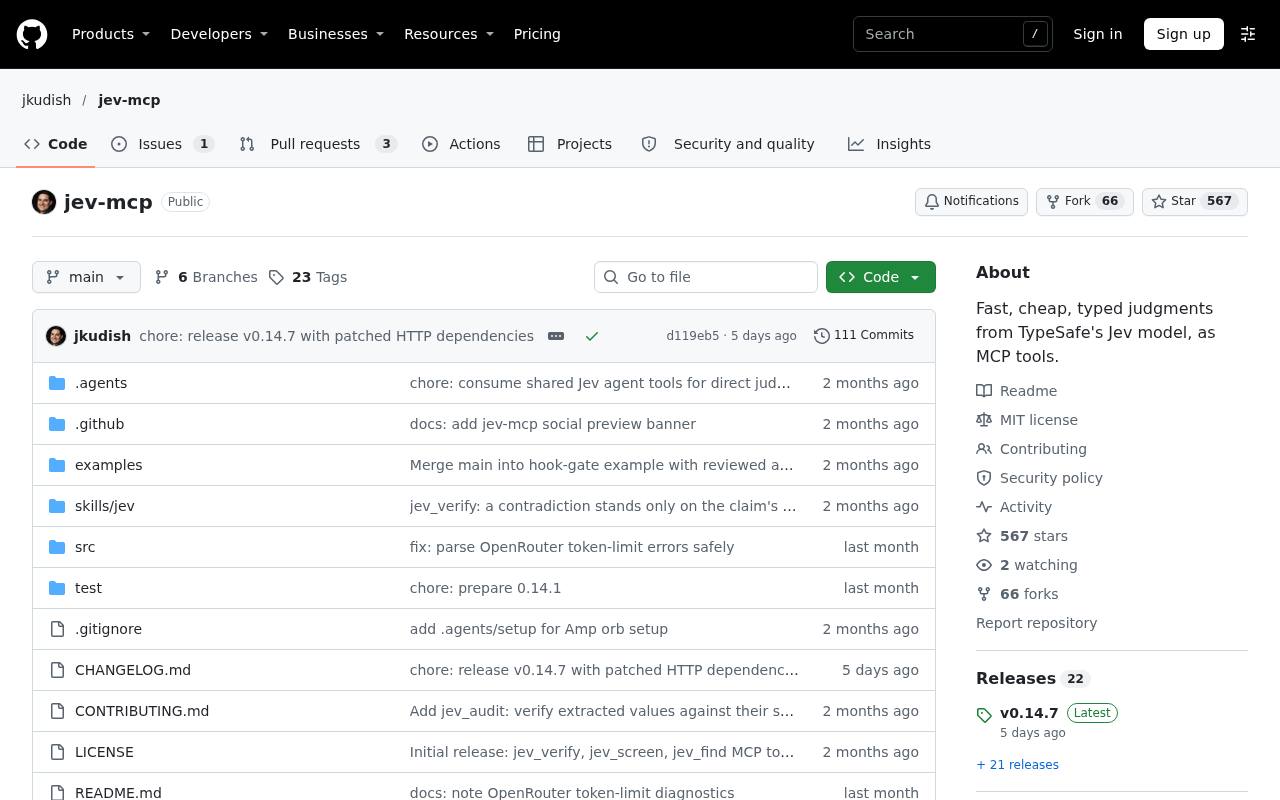
- Garde-fous. Contrôler une page récupérée ou le résultat d'un outil pour détecter une injection de consignes avant qu'il n'atteigne le modèle principal. Jev MCP et la version hébergée de Jev chez Viorant fournissent tous deux un outil
jev_screenprécisément pour cela. - Filtrage des appels d'outils. Noter une action proposée, un diff ou une déclaration d'achèvement avant son exécution ou avant que l'agent ne déclare la tâche terminée.
jev_reviewetjev_gatede Jev MCP le font pour les agents de programmation. - Tri et vérification. Étiqueter un backlog, reclasser des résultats de recherche ou vérifier chaque affirmation d'un rapport par rapport à ses sources, par lots qui seraient trop lents et trop coûteux à faire passer par un modèle de pointe.
Ce qu'ils ne doivent pas faire : répondre à des questions ouvertes, s'expliquer ou planifier. La fiche du modèle de Fastino elle-même indique que GLiNER2.5-Decide « ne raisonne pas, n'explique pas et ne répond pas à des questions ouvertes ».
Les principales options
- Jev (TypeSafe). Uniquement hébergé ; nous n'avons trouvé aucune déclaration indiquant que les poids sont publiés. TypeSafe affiche 42 $ par milliard de tokens d'entrée. Il est aussi vendu via OpenRouter et Cloudflare Workers AI, selon le README de jev-mcp. Il gère jusqu'à 255 options par question de type choice, d'après l'article de lancement de TypeSafe.
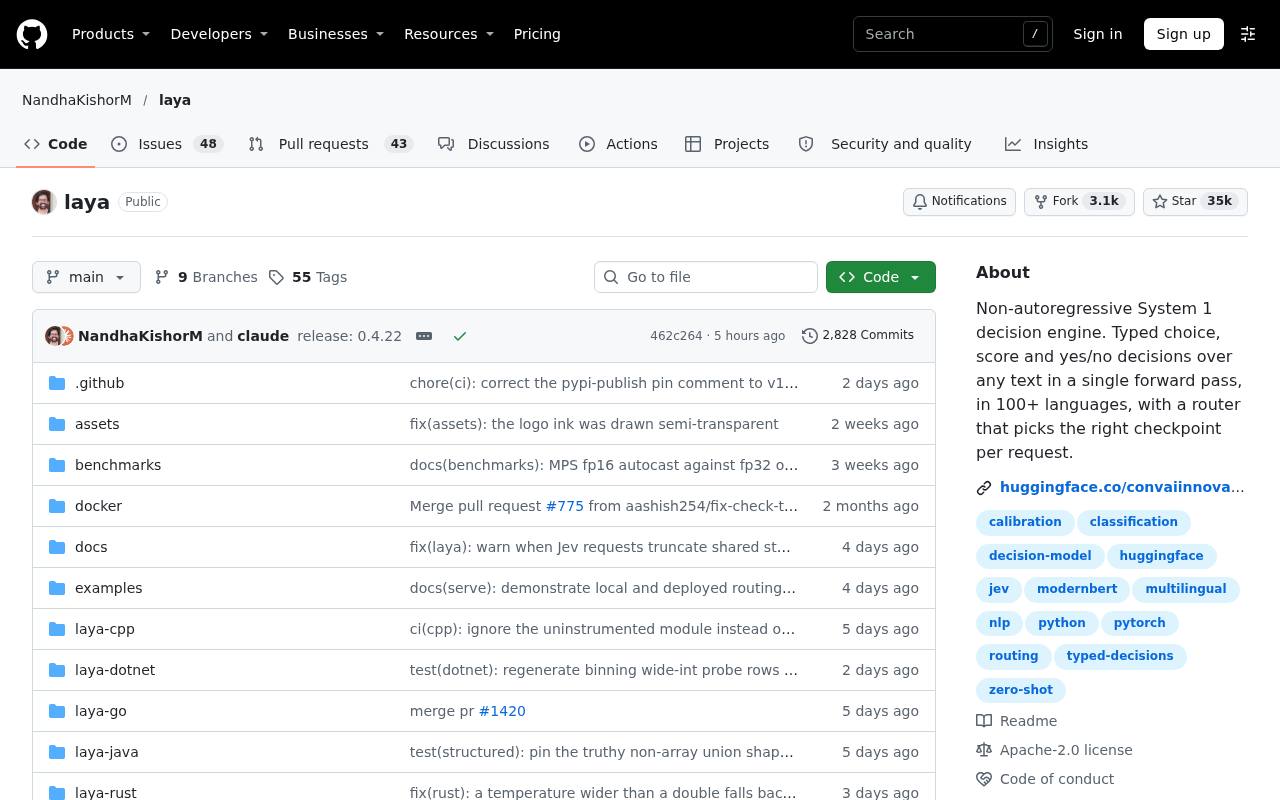
- Laya (Convai Innovations). Poids ouverts sous Apache 2.0, trois checkpoints de 322M à 421M de paramètres, et un routeur qui envoie le texte non anglais vers un checkpoint multilingue couvrant plus de 100 langues. Son README indique 32,8 ms pour une question sur un GPU T4.
- Clef et Clef-flash (Cloudflare). Publiés le 1er octobre 2026 avec des poids sous Apache 2.0, à 27B et 9B de paramètres avec un contexte de 64K tokens, sur Workers AI et Hugging Face. Ils suivent la même API System One que Jev : selon Cloudflare, changer revient à modifier l'endpoint et le nom du modèle.
- GLiNER2.5-Decide (Fastino). Un petit encodeur anglais (Fastino annonce 340M de paramètres ; le fichier de poids en contient environ 486M) sous Apache 2.0 qui tourne sur CPU, avec une variante multilingue ; la fiche indique qu'il est affiné à partir de GLiNER2.
- Perplexity Decider (pplx-decider) (Perplexity). Les modèles de décision ouverts de 27B et 4B de Perplexity, également vendus sous forme d'API à 0,02 $ par million de tokens : du texte et des images en entrée, des probabilités en sortie.
- d3 (vLLM Semantic Router) (vLLM Semantic Router). Le modèle de décision ouvert de 27B du projet vLLM Semantic Router, deuxième du Decision Index, avec entrée vidéo et service natif par vLLM.
Le modèle hébergé demande le moins de travail et les modèles ouverts offrent le plus de confidentialité. Sur le papier, Clef est le challenger ouvert le plus solide ; Laya et GLiNER2.5-Decide sont assez petits pour un ordinateur portable.
En brancher un à votre agent
Pour la plupart des gens, le serveur MCP compte autant que le modèle.
- Jev MCP (4,3) est le choix pour les agents de programmation : douze contrôles prêts à l'emploi, dont la détection d'injections, la vérification d'affirmations et la revue de diffs.
- Le serveur MCP officiel de Laya (4,2) fait tout tourner en local, avec des outils pour les lots, les longs documents et les listes restreintes.
- System One Connector (4,1) est un outil léger unique qui peut dialoguer avec Jev, une instance auto-hébergée de Laya ou de CLM, ou le d1 de Liquid AI.
- Jev sur Viorant (3,8) est un endpoint OAuth hébergé avec des crédits de départ gratuits et sans clé TypeSafe.
- Le connecteur Jev d'AnythingMCP (3,7) convient aux équipes qui veulent une seule clé partagée et auditée pour les utilisateurs de claude.ai et de ChatGPT.
Les limites, honnêtement
Presque tous les benchmarks sont ceux des éditeurs. Le changelog de Cloudflare place Clef devant Jev sur 7 des 10 benchmarks de décision, dont 94,20 contre 79,74 sur BANKING77, et Clef-flash à une latence médiane de 38,8 ms contre 524,1 ms pour Jev. La fiche de Fastino place GLiNER2.5-Decide en tête sur le propre jeu de données de Fastino, avec le routeur de Laya en dernier. Le README de Laya place Laya devant Jev sur la plupart des tâches, en utilisant des chiffres de Jev qu'il dit n'avoir jamais mesurés lui-même. Les chiffres se contredisent parce que chaque éditeur a choisi le test.
La précision en zero-shot peut être faible. Les mainteneurs de Laya écrivent que ses checkpoints de base sont « proches du hasard » sur leur propre benchmark de décisions typées (0,362 contre une référence aléatoire de 0,318), et que le chiffre phare de 0,766 provient d'un checkpoint affiné sur la partie entraînement de ce benchmark. Ils documentent aussi des demandes d'annulation formulées à la négative classées comme des annulations avec une probabilité de 0,9998, et une précision qui tombe à 0,425 sur une tâche à 77 étiquettes.
La confiance n'est pas l'exactitude. Une probabilité calibrée est l'argument de vente, mais le README de Laya note que ses checkpoints sont trop confiants tels que livrés et que la confiance « ordonne les décisions ; elle n'établit pas qu'une décision est correcte ». Ajustez les seuils sur vos propres données étiquetées.
Tout est nouveau. Le dépôt de Laya a été créé le 18 septembre 2026 ; Clef est sorti le 1er octobre ; les serveurs MCP pour Jev examinés ici ont tous moins de cinq semaines. Les numéros de version changent chaque semaine, et l'auteur de jev-mcp le qualifie de logiciel encore précoce.
Qui devrait en utiliser un
Utilisez un modèle de décision si votre agent porte de nombreuses fois le même type de jugement circonscrit (router des tickets, contrôler du contenu récupéré, filtrer des appels d'outils) et si vous savez décrire à quoi ressemblent les bonnes réponses. Commencez par Jev via Jev MCP si vous voulez de bons résultats sans rien entraîner et pouvez envoyer des données à un service hébergé. Choisissez Laya ou Clef si les données doivent rester sur votre matériel, et prévoyez du temps pour étiqueter des exemples et ajuster les seuils.
Passez votre chemin si vos décisions sont rares, ouvertes ou exigent une explication ; un modèle de pointe reste alors le meilleur outil. Et quel que soit votre choix, gardez un modèle de pointe ou un humain derrière les cas à faible confiance. Le gain vient de la rapidité sur les décisions faciles, pas du fait de laisser un modèle de 400M de paramètres tout décider.