
L'OCR en Rust : dix moteurs open source comparés, et lequel utiliser pour quoi
Par Sheela ·
Si vous voulez lire du texte dans des images au sein d'un programme Rust, la voie habituelle consistait à se lier à Tesseract et à livrer ses bibliothèques C++. Ce n'est plus la seule. Il existe désormais des lecteurs en pur Rust, des surcouches autour des modèles PaddleOCR de Baidu, des portages de grands modèles de vision qui transforment une page en Markdown, et des pipelines documentaires complets. Ils résolvent des problèmes différents, et plusieurs sont le projet d'une seule personne. En voici dix, regroupés selon ce qu'ils font.
Moteurs en pur Rust avec leurs propres modèles
Ceux-ci se compilent avec cargo seul, sans chaîne d'outils C++. Ils lisent des lignes de texte ; ils ne comprennent ni les tableaux ni la mise en page.
- Ocrs (3,8) est le choix mûr. Il fait tourner de petits modèles via un moteur d'inférence en Rust, fonctionne en WebAssembly, et sa crate compte environ 477 000 téléchargements. Il ne lit que l'alphabet latin et se présente comme une préversion précoce.
- yingkitw/ocr promet plus de 25 langues, onze formats de sortie et un modèle de moins de 5MB intégré au binaire. Il compte 3 étoiles, aucune version publiée sur GitHub, et son README indique Apache-2.0 alors que son fichier de licence indique MIT. Intéressant, mais pas encore quelque chose dont dépendre.
- texo-ocr (studio-ransom/best-ocr-rust) fait une seule chose précise : il transforme l'image d'une formule mathématique en LaTeX, en environ 4 000 lignes de Rust sans crate tierce, assez léger pour un Raspberry Pi. Il est sous AGPL-3.0, ce qui compte si vous l'intégrez à un produit, compte 2 étoiles, et tous ses commits datent des 9 et 10 août 2026.
Surcouches PaddleOCR et RapidOCR
Les modèles PaddleOCR de Baidu sont la réponse habituelle pour le chinois, le japonais, le coréen et d'autres écritures non latines. Ces projets les font tourner sans Python.
- ocr-rs (3,7), anciennement rust-paddle-ocr, est le plus complet. Il prend en charge PP-OCR v4, v5 et v6, couvre 50 langues avec les modèles v6, et propose CUDA, Vulkan, Metal et OpenCL. Il se lie au moteur C++ MNN d'Alibaba et n'a qu'un mainteneur principal.
- rusto-rs fait tourner les modèles PaddleOCR en pur Rust et publie des paquets pour Python, Node, WebAssembly, React Native, Flutter et .NET. L'auteur annonce une CLI de 5,4MB et un pic de mémoire de 85 à 120MB. Il compte 51 étoiles et est presque entièrement l'œuvre d'un seul développeur ; la v0.3.2 est sortie le 25 octobre 2026.
- rapidocr-rs porte le pipeline RapidOCR en Rust sur ONNX Runtime, sans OpenCV. Son README précise qu'il ne remplace pas entièrement le paquet Python et recense les écarts de parité. 5 étoiles.
- ocrs-cjk est un fork d'Ocrs qui ajoute les modèles PaddleOCR pour le chinois, le japonais et le coréen et produit des PDF consultables. Il compte 4 étoiles, une seule version (juin 2026) et aucun commit depuis le 26 juin.
Moteurs à modèles de vision : des pages entières en Markdown
Ceux-ci font tourner des modèles vision-langage qui lisent une page comme le ferait une personne, en conservant les tableaux et l'ordre de lecture. Ils ont besoin de gigaoctets de mémoire, pas de mégaoctets.
- deepseek-ocr.rs (3,6) fait tourner DeepSeek-OCR, PaddleOCR-VL et dots.ocr sur CPU, Apple Metal ou (en alpha) CUDA, derrière un serveur compatible avec OpenAI. PaddleOCR-VL tient dans environ 9GB. C'est le projet d'un seul développeur, et rien n'a été publié depuis le 21 février 2026.
- franken_ocr (3,5) fait tourner Unlimited-OCR de Baidu sur CPU avec du code int8 écrit à la main. Selon les chiffres de l'auteur lui-même, il est environ trois fois plus rapide sur CPU que le code Python standard de Hugging Face. Il a un seul auteur, qui n'accepte pas de contributions extérieures, et sa licence exclut OpenAI, Anthropic et toute personne travaillant pour eux.
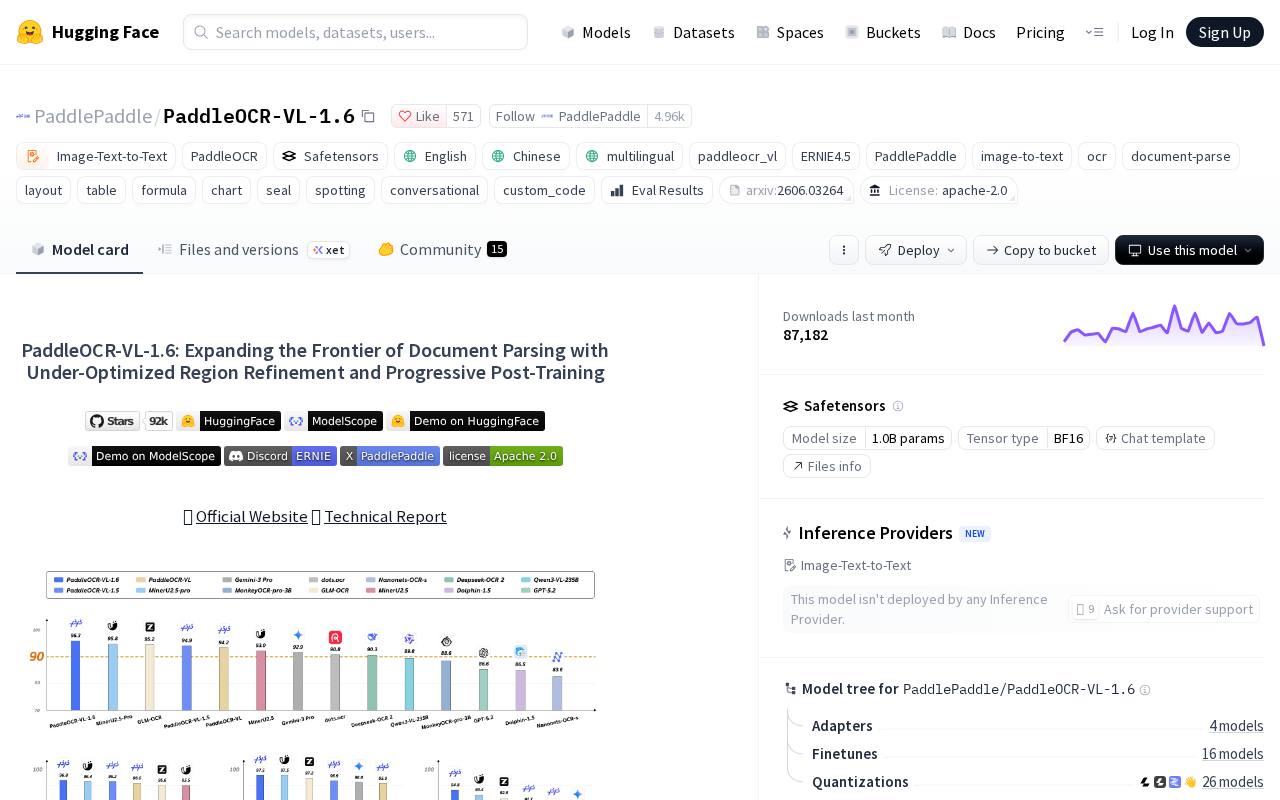
Les modèles eux-mêmes sont testés séparément : PaddleOCR-VL 1.6 (4,4) a le score OmniDocBench publié le plus élevé des trois, selon les chiffres de Baidu, Unlimited-OCR (4,1) traite les longs documents en une seule passe, et DeepSeek-OCR 2 (3,7) a pris du retard.
Pipelines documentaires
- Xberg (4,1), le nouveau nom de Kreuzberg, est moins un moteur d'OCR que tout ce qui l'entoure. Il ouvre 107 formats de fichiers, propose huit back-ends d'OCR, de Tesseract aux modèles de vision ci-dessus, et peut être appelé depuis 15 langages de programmation. Utilisez une version postérieure à 1.3.3 : les précédentes avaient une faille de gravité élevée dans leur API sans authentification.
- Si Python vous convient, Docling (4,5) reste notre analyseur le mieux noté pour les PDF aux tableaux complexes.
Lequel utiliser
Captures d'écran ou étiquettes en anglais dans une application Rust ou web : Ocrs. Texte chinois, japonais ou coréen : ocr-rs. Documents entiers en Markdown sur un Mac : deepseek-ocr.rs avec PaddleOCR-VL. Pas de GPU du tout et de longs documents numérisés : franken_ocr, si sa licence et son mainteneur unique vous conviennent. De nombreux types de fichiers, pas seulement des images, depuis un autre langage que Python : Xberg. Tout ce qui compte moins de 55 étoiles mérite d'être suivi, pas qu'on bâtisse une entreprise dessus.