
Análises Joias de código aberto
OCR em Rust: dez engines de código aberto comparadas, e qual usar para quê
Por Sheela ·
Se você quer ler texto de imagens dentro de um programa em Rust, o caminho habitual era fazer binding com o Tesseract e distribuir suas bibliotecas C++. Esse não é mais o único. Agora existem leitores em Rust puro, wrappers em torno dos modelos PaddleOCR da Baidu, ports de grandes modelos de visão que transformam uma página em Markdown e pipelines completos de documentos. Eles resolvem problemas diferentes, e vários são projeto de uma pessoa só. Eis dez, agrupados pelo que fazem.
Engines em Rust puro com modelos próprios
Estas compilam só com cargo, sem toolchain de C++. Elas leem linhas de texto; não entendem tabelas nem o layout da página.
- O Ocrs (3,8) é a escolha madura. Roda modelos pequenos por uma engine de inferência em Rust, funciona em WebAssembly, e seu crate tem cerca de 477.000 downloads. Lê só o alfabeto latino e se define como uma prévia inicial.
- O yingkitw/ocr promete mais de 25 idiomas, onze formatos de saída e um modelo de menos de 5MB embutido no binário. Tem 3 estrelas, nenhuma release no GitHub, e seu README diz Apache-2.0 enquanto o arquivo de licença é MIT. Interessante, mas ainda não é algo de que se possa depender.
- O texo-ocr (studio-ransom/best-ocr-rust) faz uma tarefa específica: transforma a imagem de uma fórmula matemática em LaTeX, em cerca de 4.000 linhas de Rust sem crates de terceiros, pequeno o bastante para um Raspberry Pi. É AGPL-3.0, o que importa se você o distribuir em um produto, tem 2 estrelas, e todos os commits foram feitos em 9 e 10 de agosto de 2026.
Wrappers de PaddleOCR e RapidOCR
Os modelos PaddleOCR da Baidu são a resposta habitual para chinês, japonês, coreano e outras escritas não latinas. Estes projetos os rodam sem Python.
- O ocr-rs (3,7), antes rust-paddle-ocr, é o mais completo. Aceita PP-OCR v4, v5 e v6, cobre 50 idiomas com os modelos v6 e oferece CUDA, Vulkan, Metal e OpenCL. Faz link com o runtime MNN em C++ da Alibaba e tem um mantenedor principal.
- O rusto-rs roda modelos PaddleOCR em Rust puro e publica pacotes para Python, Node, WebAssembly, React Native, Flutter e .NET. O autor relata uma CLI de 5,4MB e pico de memória de 85 a 120MB. Tem 51 estrelas e é quase inteiramente trabalho de um desenvolvedor; a v0.3.2 saiu em 25 de outubro de 2026.
- O rapidocr-rs porta o pipeline do RapidOCR para Rust sobre o ONNX Runtime, sem OpenCV. Seu README diz que não é um substituto completo do pacote Python e acompanha as lacunas de paridade. 5 estrelas.
- O ocrs-cjk é um fork do Ocrs que acrescenta modelos PaddleOCR para chinês, japonês e coreano e gera PDFs pesquisáveis. Tem 4 estrelas, uma release (junho de 2026) e nenhum commit desde 26 de junho.
Engines com modelos de visão: páginas inteiras para Markdown
Estas rodam modelos de visão e linguagem que leem uma página como uma pessoa lê, preservando tabelas e ordem de leitura. Precisam de gigabytes de memória, não de megabytes.
- O deepseek-ocr.rs (3,6) roda DeepSeek-OCR, PaddleOCR-VL e dots.ocr em CPU, Apple Metal ou (em alfa) CUDA, por trás de um servidor compatível com a API da OpenAI. O PaddleOCR-VL cabe em cerca de 9GB. É projeto de um desenvolvedor, e nada foi enviado desde 21 de fevereiro de 2026.
- O franken_ocr (3,5) roda o Unlimited-OCR da Baidu em CPU com código int8 escrito à mão. Os números do próprio autor o mostram cerca de três vezes mais rápido em CPU que o código Python padrão do Hugging Face. Tem um único autor, que não aceita contribuições externas, e sua licença exclui a OpenAI, a Anthropic e qualquer pessoa que trabalhe para elas.
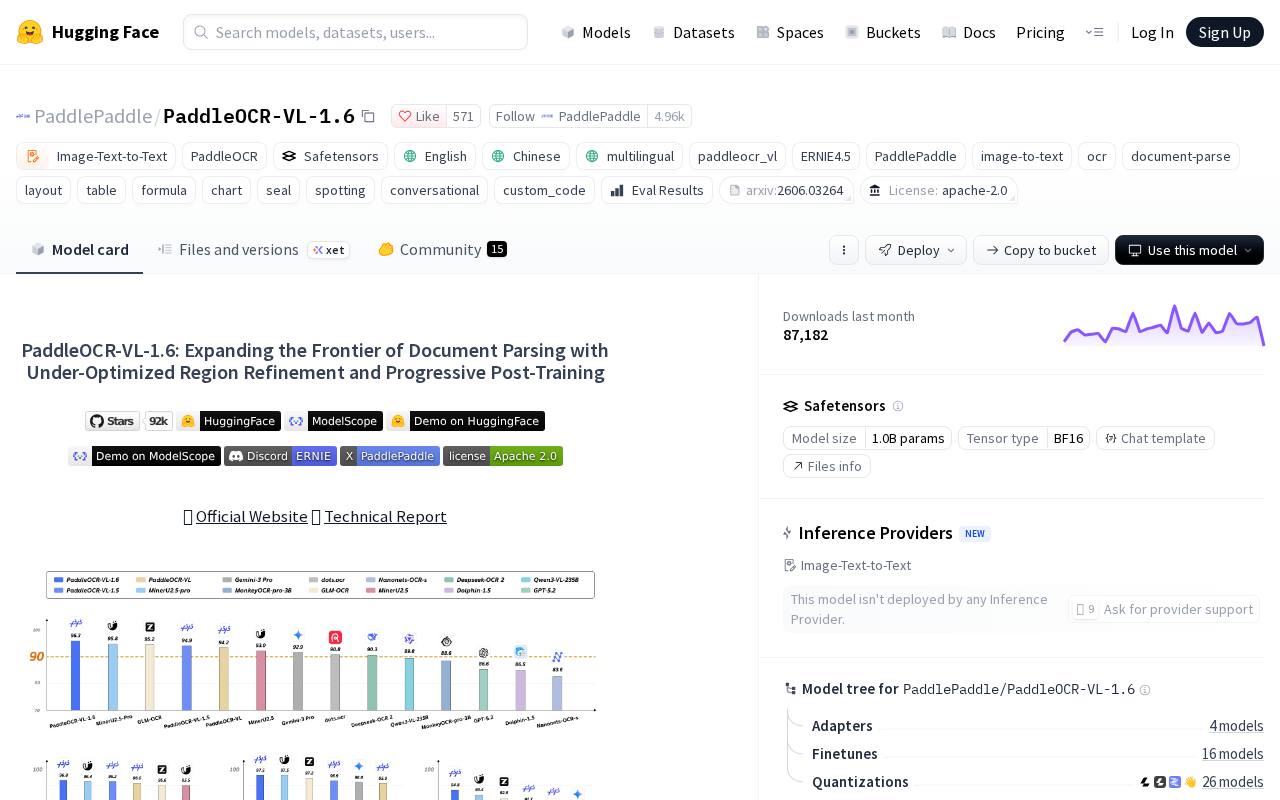
Os modelos em si são analisados à parte: o PaddleOCR-VL 1.6 (4,4) tem a maior pontuação publicada no OmniDocBench dos três, segundo os números da própria Baidu, o Unlimited-OCR (4,1) processa documentos longos de uma só vez, e o DeepSeek-OCR 2 (3,7) ficou para trás.
Pipelines de documentos
- O Xberg (4,1), o antigo Kreuzberg, é menos uma engine de OCR e mais tudo o que fica em volta de uma. Abre 107 formatos de arquivo, oferece oito backends de OCR, do Tesseract aos modelos de visão acima, e pode ser chamado de 15 linguagens de programação. Use uma versão mais nova que a 1.3.3: as anteriores tinham uma falha de alta gravidade na API sem autenticação.
- Se Python não for problema, o Docling (4,5) continua sendo o parser mais bem avaliado por nós para PDFs com tabelas complexas.
Qual usar
Capturas de tela ou etiquetas em inglês em um app Rust ou de navegador: Ocrs. Texto em chinês, japonês ou coreano: ocr-rs. Documentos inteiros para Markdown em um Mac: deepseek-ocr.rs com PaddleOCR-VL. Nenhuma GPU e documentos digitalizados longos: franken_ocr, se a licença e o mantenedor único servirem para você. Muitos tipos de arquivo, não só imagens, a partir de uma linguagem que não seja Python: Xberg. Tudo abaixo de 55 estrelas vale acompanhar, não construir um negócio em cima.