
RustでのOCR:10のオープンソースエンジンを比較し、用途ごとの選び方を示す
執筆: Sheela ·
Rustのプログラムの中で画像から文字を読み取りたいなら、これまでの定番はTesseractにバインドしてそのC++ライブラリを同梱する方法でした。今はそれだけではありません。純Rustの読み取りエンジン、BaiduのPaddleOCRモデルのラッパー、ページをMarkdownに変える大規模な視覚モデルの移植版、そして文書処理のパイプライン一式があります。解決する問題はそれぞれ異なり、いくつかは個人のプロジェクトです。ここでは10個を、できることで分類して紹介します。
独自のモデルを持つ純Rustのエンジン
これらはcargoだけでビルドでき、C++のツールチェーンは不要です。文字の行を読み取りますが、表やページのレイアウトは理解しません。
- Ocrs(3.8)は成熟した選択肢です。Rustの推論エンジンで小さなモデルを動かし、WebAssemblyでも動き、crateのダウンロード数は約477,000です。読めるのはラテン文字だけで、自らを初期のプレビュー版と呼んでいます。
- yingkitw/ocrは、25以上の言語、11の出力形式、バイナリに組み込まれた5MB未満のモデルを約束しています。スターは3、GitHubのリリースはなく、READMEにはApache-2.0とある一方でライセンスファイルはMITです。興味深いものの、まだ頼れるものではありません。
- texo-ocr(studio-ransom/best-ocr-rust)は1つの狭い仕事をします。数式の画像を、サードパーティのcrateを使わない約4,000行のRustでLaTeXに変えるもので、Raspberry Piでも動くほど小さいです。ライセンスはAGPL-3.0で、製品に組み込むなら重要な点です。スターは2で、コミットはすべて2026年8月9日と10日に行われました。
PaddleOCRとRapidOCRのラッパー
中国語、日本語、韓国語などのラテン文字以外の文字には、BaiduのPaddleOCRモデルが定番の答えです。これらのプロジェクトは、Pythonなしでそれを動かします。
- 旧名rust-paddle-ocrのocr-rs(3.7)は最も充実しています。PP-OCRのv4、v5、v6に対応し、v6のモデルで50の言語を扱い、CUDA、Vulkan、Metal、OpenCLを使えます。AlibabaのC++製MNNランタイムをリンクしており、主なメンテナーは1人です。
- rusto-rsはPaddleOCRのモデルを純Rustで動かし、Python、Node、WebAssembly、React Native、Flutter、.NET向けのパッケージを公開しています。作者は、CLIが5.4MB、ピーク時のメモリが85〜120MBと報告しています。スターは51で、ほぼ全体が1人の開発者の作品です。v0.3.2は2026年10月25日に出ました。
- rapidocr-rsは、RapidOCRのパイプラインをOpenCVなしでONNX Runtime上のRustに移植したものです。READMEでは、Pythonのパッケージの完全な代替ではないとし、同等性の差を管理しています。スターは5です。
- ocrs-cjkはOcrsのフォークで、中国語、日本語、韓国語向けのPaddleOCRモデルを加え、検索可能なPDFを書き出します。スターは4、リリースは1回(2026年6月)で、6月26日以降コミットがありません。
視覚モデルのエンジン:ページ全体をMarkdownに
これらは、人と同じようにページを読み、表や読む順序を保つ視覚言語モデルを動かします。必要なメモリはメガバイトではなくギガバイト単位です。
- deepseek-ocr.rs(3.6)は、DeepSeek-OCR、PaddleOCR-VL、dots.ocrを、CPU、Apple Metal、または(アルファ版の)CUDAで、OpenAI互換のサーバーの裏で動かします。PaddleOCR-VLは約9GBに収まります。1人の開発者のプロジェクトで、2026年2月21日以降何もプッシュされていません。
- franken_ocr(3.5)は、BaiduのUnlimited-OCRを手書きのint8のコードでCPU上で動かします。作者自身の数字では、CPUで標準のHugging FaceのPythonのコードより約3倍速くなっています。作者は1人で外部からの貢献を受け付けず、ライセンスはOpenAI、Anthropic、そしてそのために働く人を対象外としています。
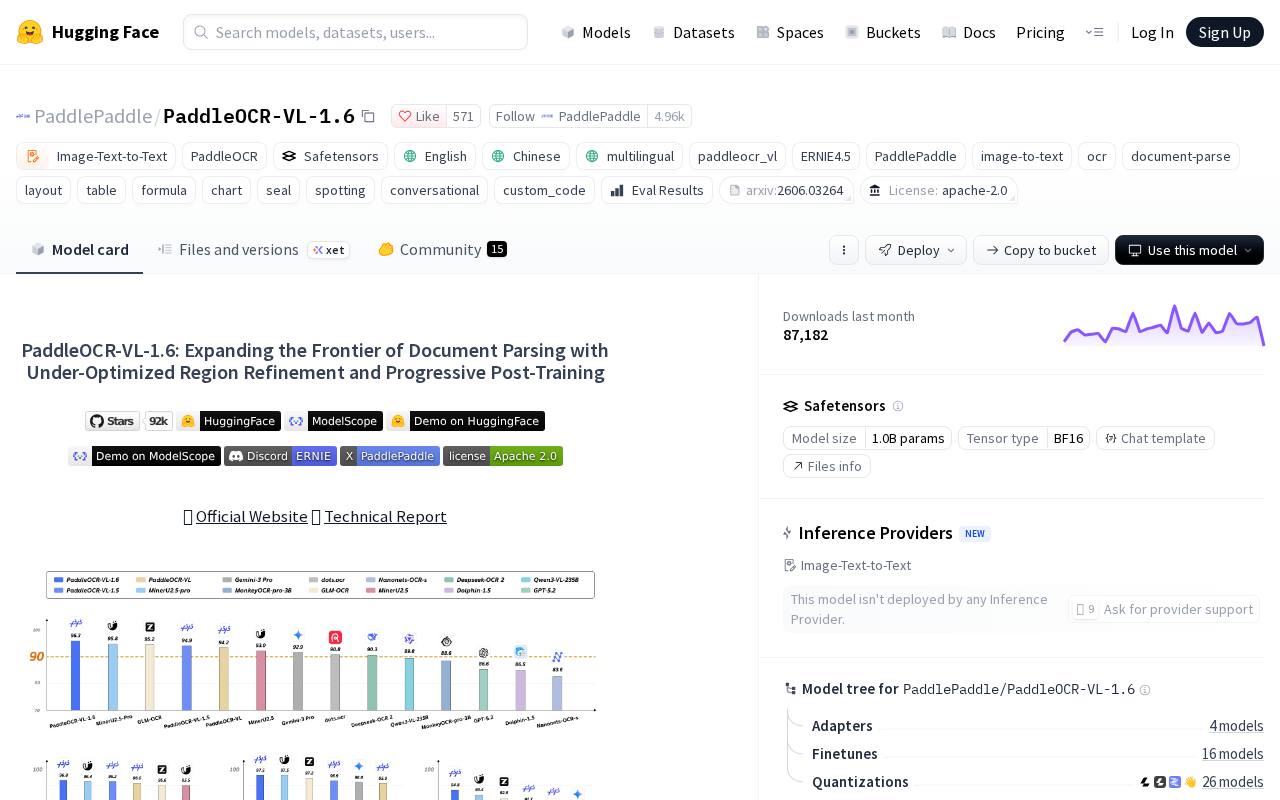
モデル自体は別にレビューしています。Baidu自身の数字では、3つの中でOmniDocBenchの公表スコアが最も高いのはPaddleOCR-VL 1.6(4.4)です。Unlimited-OCR(4.1)は長い文書を1回で処理し、DeepSeek-OCR 2(3.7)は後れを取っています。
文書処理のパイプライン
- Kreuzbergから名前を変えたXberg(4.1)は、OCRエンジンというより、その周りのすべてです。107のファイル形式を開き、Tesseractから上記の視覚モデルまで8つのOCRバックエンドを備え、15のプログラミング言語から呼び出せます。1.3.3より新しいバージョンを使ってください。それ以前のものには、認証のないAPIに深刻度の高い欠陥がありました。
- Pythonでもよいなら、複雑な表を含むPDFのパーサーとしてはDocling(4.5)が引き続き私たちの最高評価です。
どれを使うか
Rustやブラウザのアプリでの英語のスクリーンショットやラベルなら、Ocrs。中国語、日本語、韓国語の文字なら、ocr-rs。Macで文書全体をMarkdownにするなら、deepseek-ocr.rsとPaddleOCR-VL。GPUがまったくなく、スキャンした長い文書なら、ライセンスとメンテナーが1人であることを受け入れられる場合にfranken_ocr。画像だけでなく多くのファイル形式を、Python以外の言語から扱うなら、Xberg。スターが55未満のものはすべて、見守る価値はあっても、事業の土台にするものではありません。