
Rust로 하는 OCR: 오픈소스 엔진 열 개 비교와 용도별 선택
작성자 Sheela ·
Rust 프로그램 안에서 이미지의 텍스트를 읽으려면, 예전에는 Tesseract에 바인딩하고 그 C++ 라이브러리를 함께 배포하는 것이 보통이었습니다. 이제는 그것만이 유일한 길이 아닙니다. 순수 Rust 판독기, Baidu의 PaddleOCR 모델을 감싼 래퍼, 페이지를 Markdown으로 바꾸는 대형 비전 모델 포트, 전체 문서 파이프라인이 있습니다. 서로 다른 문제를 풀고, 여럿은 한 사람의 프로젝트입니다. 하는 일에 따라 묶은 열 개를 소개합니다.
자체 모델을 갖춘 순수 Rust 엔진
이들은 C++ 툴체인 없이 cargo만으로 빌드됩니다. 텍스트 줄을 읽을 뿐, 표나 페이지 레이아웃은 이해하지 못합니다.
- Ocrs(3.8)는 성숙한 선택입니다. Rust 추론 엔진으로 작은 모델을 돌리고, WebAssembly에서 작동하며, 크레이트 다운로드는 약 477,000회입니다. 라틴 문자만 읽고 스스로를 초기 프리뷰라고 부릅니다.
- yingkitw/ocr는 25개 이상의 언어, 열한 가지 출력 형식, 바이너리에 내장된 5MB 미만 모델을 약속합니다. 별은 3개, GitHub 릴리스는 없고, README는 Apache-2.0이라고 하는데 라이선스 파일은 MIT입니다. 흥미롭지만 아직 의존할 만한 것은 아닙니다.
- texo-ocr(studio-ransom/best-ocr-rust)는 한 가지 좁은 일을 합니다. 수학 공식 이미지를 LaTeX로 바꾸며, 서드파티 크레이트 없이 약 4,000줄의 Rust로 되어 있어 Raspberry Pi에도 올라갈 만큼 작습니다. AGPL-3.0이라 제품에 넣어 배포한다면 중요하고, 별은 2개이며, 모든 커밋이 2026년 8월 9일과 10일에 올라왔습니다.
PaddleOCR와 RapidOCR 래퍼
Baidu의 PaddleOCR 모델은 중국어, 일본어, 한국어를 비롯한 비라틴 문자에 대한 흔한 답입니다. 이 프로젝트들은 Python 없이 그 모델을 돌립니다.
- 이전 이름이 rust-paddle-ocr인 ocr-rs(3.7)가 가장 완성도가 높습니다. PP-OCR v4, v5, v6를 지원하고, v6 모델로 50개 언어를 다루며, CUDA, Vulkan, Metal, OpenCL을 제공합니다. Alibaba의 C++ MNN 런타임을 링크하고, 주 관리자는 한 명입니다.
- rusto-rs는 PaddleOCR 모델을 순수 Rust로 돌리며 Python, Node, WebAssembly, React Native, Flutter, .NET용 패키지를 배포합니다. 작성자는 CLI가 5.4MB이고 최대 메모리가 85에서 120MB라고 보고합니다. 별은 51개이고 거의 전부 개발자 한 명의 작업이며, v0.3.2가 2026년 10월 25일에 나왔습니다.
- rapidocr-rs는 RapidOCR 파이프라인을 OpenCV 없이 ONNX Runtime 기반 Rust로 옮깁니다. README는 Python 패키지를 완전히 대체하지는 못한다고 밝히고 기능 차이를 추적합니다. 별은 5개입니다.
- ocrs-cjk는 Ocrs의 포크로, 중국어, 일본어, 한국어용 PaddleOCR 모델을 더하고 검색 가능한 PDF를 씁니다. 별은 4개, 릴리스는 하나(2026년 6월)이며, 6월 26일 이후 커밋이 없습니다.
비전 모델 엔진: 페이지 전체를 Markdown으로
이들은 사람처럼 페이지를 읽어 표와 읽는 순서를 유지하는 비전-언어 모델을 돌립니다. 메가바이트가 아니라 기가바이트 단위의 메모리가 필요합니다.
- deepseek-ocr.rs(3.6)는 DeepSeek-OCR, PaddleOCR-VL, dots.ocr를 CPU, Apple Metal, 또는 (알파 단계인) CUDA에서 OpenAI 호환 서버 뒤로 돌립니다. PaddleOCR-VL은 약 9GB에 들어갑니다. 개발자 한 명의 프로젝트이며, 2026년 2월 21일 이후 푸시된 것이 없습니다.
- franken_ocr(3.5)는 Baidu의 Unlimited-OCR을 직접 작성한 int8 코드로 CPU에서 돌립니다. 작성자 자체 수치로는 CPU에서 표준 Hugging Face Python 코드보다 약 세 배 빠릅니다. 작성자는 한 명이고 외부 기여를 받지 않으며, 라이선스는 OpenAI, Anthropic, 그리고 그곳에서 일하는 모든 사람을 제외합니다.
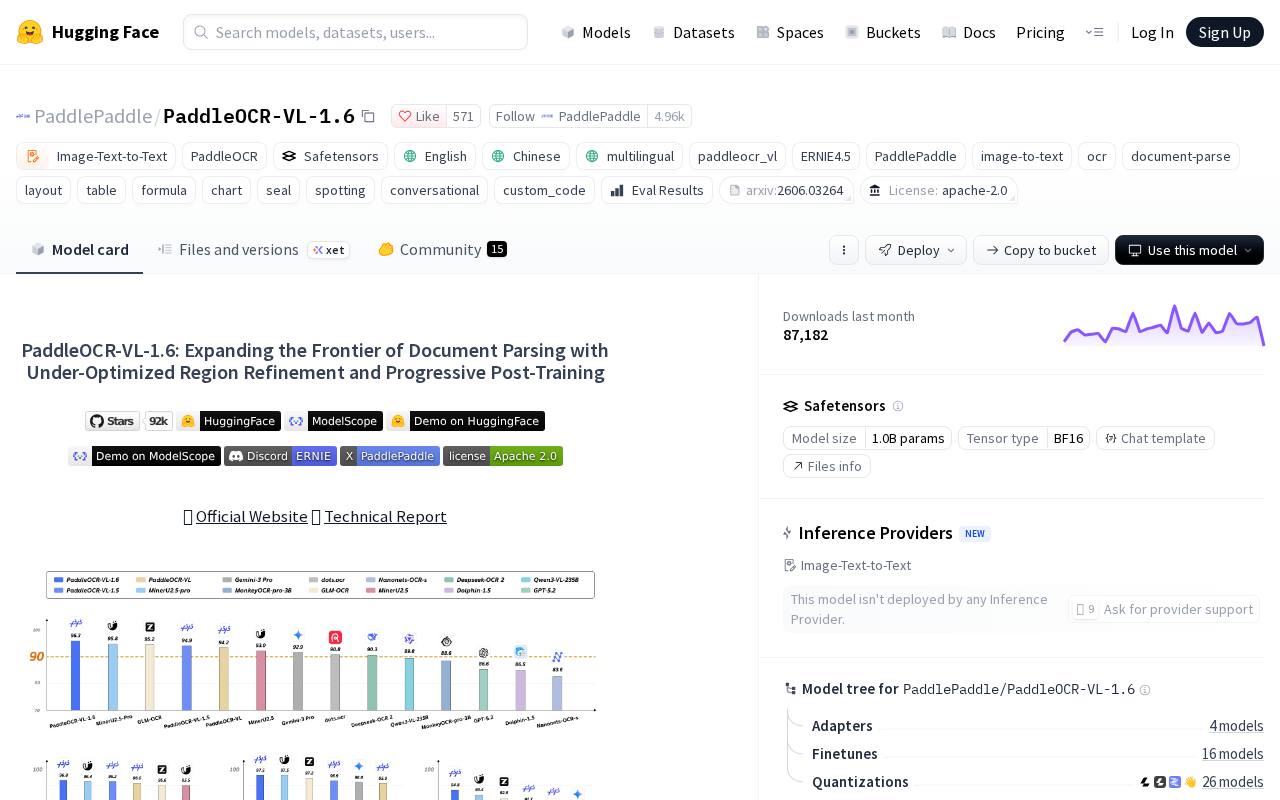
모델 자체는 따로 리뷰했습니다. PaddleOCR-VL 1.6(4.4)은 Baidu 자체 수치로 셋 가운데 공개된 OmniDocBench 점수가 가장 높고, Unlimited-OCR(4.1)은 긴 문서를 한 번에 처리하며, DeepSeek-OCR 2(3.7)는 뒤처졌습니다.
문서 파이프라인
- Kreuzberg에서 이름을 바꾼 Xberg(4.1)는 OCR 엔진이라기보다 그 주변의 모든 것입니다. 107가지 파일 형식을 열고, Tesseract부터 위의 비전 모델까지 여덟 가지 OCR 백엔드를 제공하며, 15개 프로그래밍 언어에서 호출할 수 있습니다. 1.3.3보다 새로운 버전을 쓰십시오. 이전 버전에는 인증 없는 API에 심각도 높은 결함이 있었습니다.
- Python을 써도 된다면 Docling(4.5)이 복잡한 표가 있는 PDF에 대해 여전히 저희가 가장 높이 평가하는 파서입니다.
무엇을 쓸까
Rust나 브라우저 앱에서 영어 스크린샷이나 라벨을 읽는다면 Ocrs입니다. 중국어, 일본어, 한국어 텍스트라면 ocr-rs입니다. Mac에서 문서 전체를 Markdown으로 바꾼다면 PaddleOCR-VL과 함께 쓰는 deepseek-ocr.rs입니다. GPU가 전혀 없고 스캔한 긴 문서를 다룬다면, 라이선스와 관리자 한 명이라는 조건이 괜찮을 경우 franken_ocr입니다. 이미지뿐 아니라 여러 파일 형식을 Python이 아닌 언어에서 다룬다면 Xberg입니다. 별이 55개 미만인 것은 모두 지켜볼 가치는 있지만, 사업을 걸 만한 것은 아닙니다.