
La liste restreinte des modèles ouverts, vérifiée
Par Andrew Miller ·
Les listes restreintes de modèles à poids ouverts vieillissent vite. Nous en avons pris dix qui y reviennent sans cesse et avons confronté chacun à sa fiche de modèle et aux pages de l'éditeur. Plusieurs ont été retirés ou dépassés.
Toujours à tester
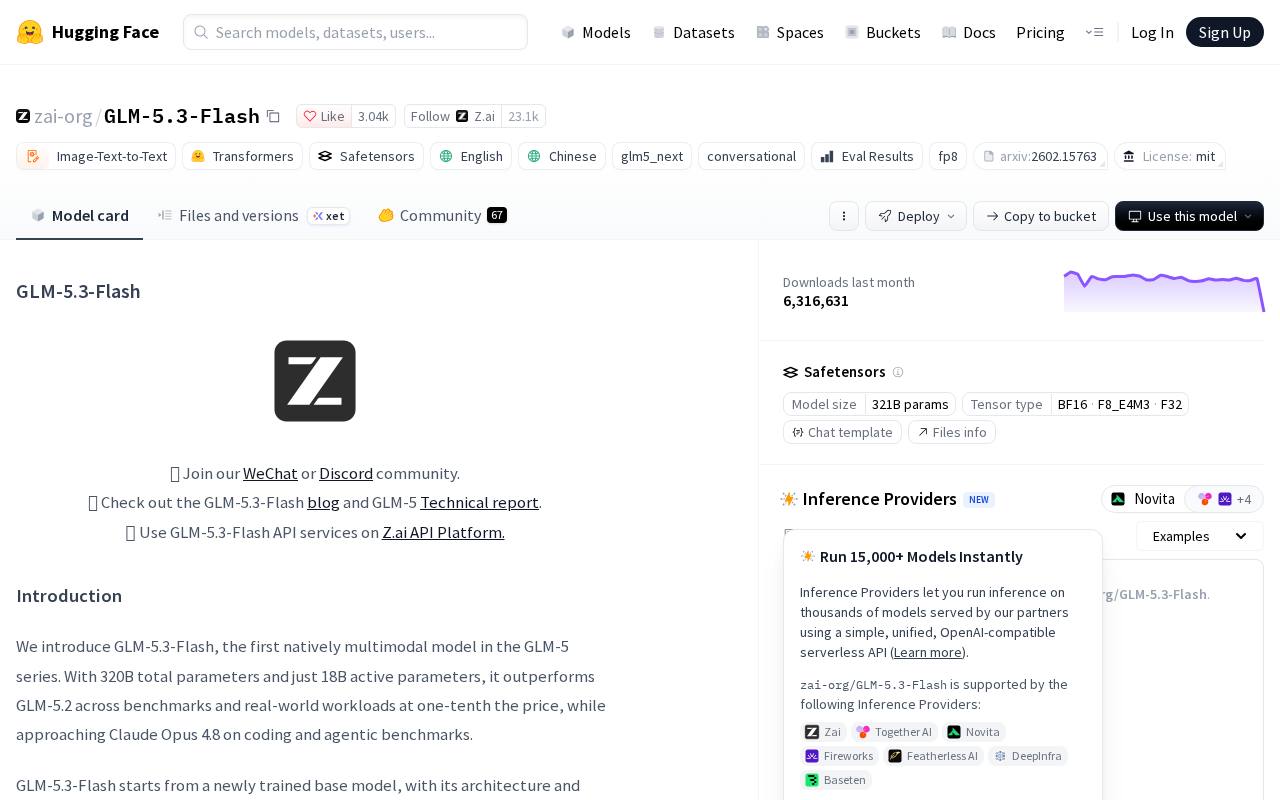
- GLM-5.3-Flash (4,3) : le modèle mixture-of-experts de Z.ai sous licence MIT, avec entrée image et vidéo et un contexte de 1M de tokens, à 0,15 $ par million de tokens d'entrée et 0,50 $ en sortie sur l'API de Z.ai. Ses benchmarks sont ceux de Z.ai, et les poids exigent encore un serveur multi-GPU.
- Gemma 4 (4,4) : les tailles E2B et E4B sont les choix de Google pour les téléphones et les appareils en périphérie, et elles acceptent l'audio en plus des images. Apache 2.0.
- Granite 4.2 (4,0) : les modèles de raisonnement denses d'IBM en 3B, 8B et 30B sous Apache 2.0. Texte uniquement, et tous les benchmarks sont ceux d'IBM.
Bien pour des tâches ciblées
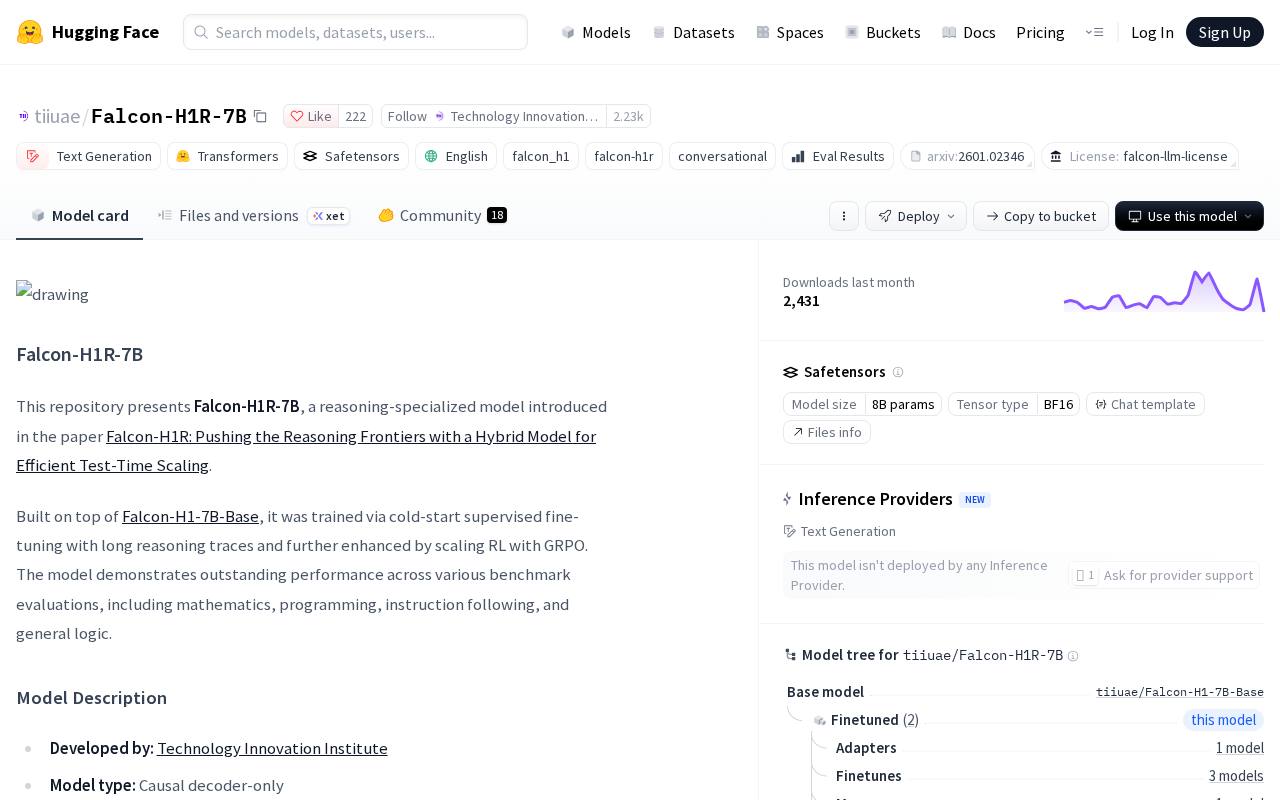
- Falcon-H1R-7B (3,6) : très fort en mathématiques pour un modèle 7B, faible sur les tâches d'agent. La licence Falcon LLM demande une attribution et une politique d'usage acceptable : elle n'est donc pas aussi simple qu'Apache 2.0. Le Falcon-H1-3B-Base associé est un modèle de base de 2025 que nous n'ajouterions pas à un test aujourd'hui.
- SmolLM3-3B (3,5) : le petit modèle le plus transparent, avec sa recette d'entraînement complète publiée. Des modèles 3B et 4B plus récents le battent en capacités.
- Devstral Small 2 (3,6) : un modèle de programmation de 24B sous Apache 2.0 qui tourne sur une seule RTX 4090. Mistral a retiré la version API en mars 2026 : vous devrez donc l'auto-héberger.
Dépassés ou retirés
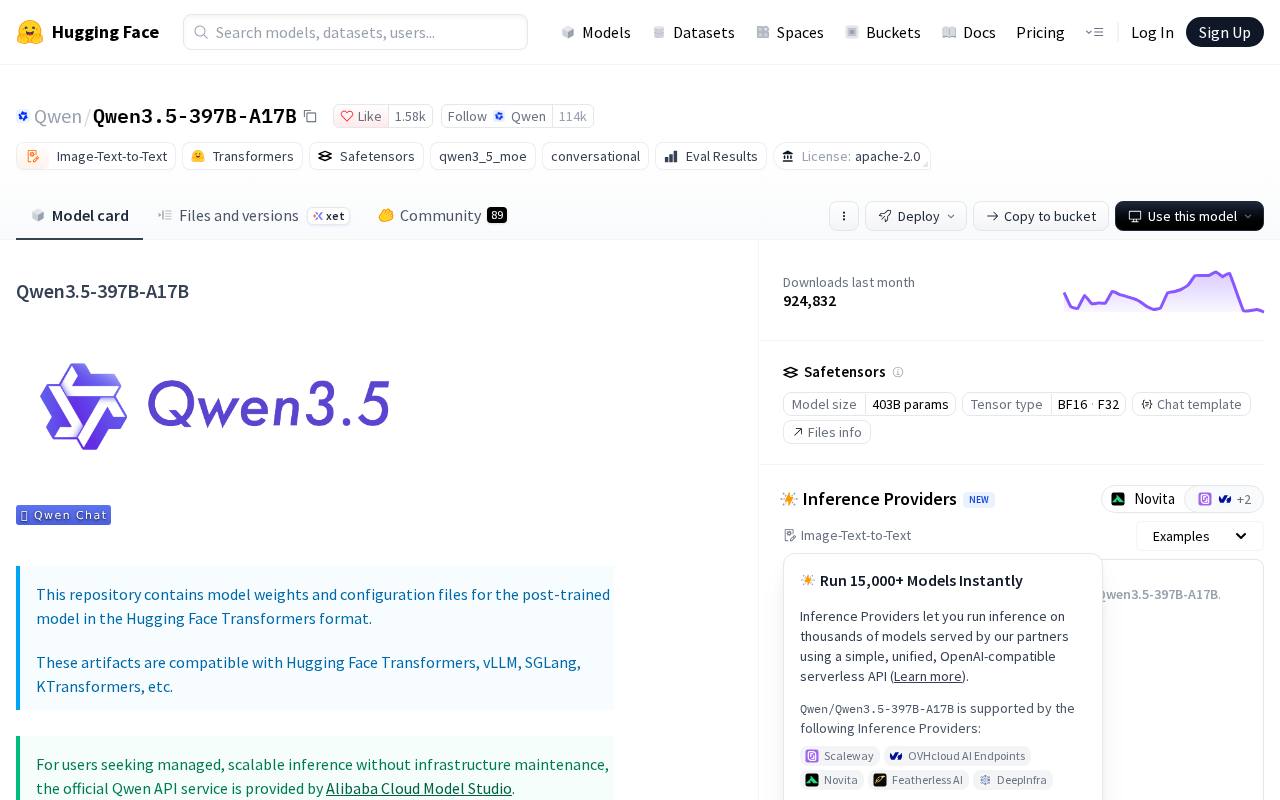
- Qwen3.5-397B-A17B (3,8) a été remplacé par Qwen3.6 et Qwen3.8.
- Devstral 2 (3,1) a été retiré de l'API de Mistral en juillet 2026, qui oriente les utilisateurs vers Mistral Medium 3.5. Sa licence MIT modifiée exclut en outre les entreprises dont le chiffre d'affaires mensuel dépasse 20 millions de dollars.
- Phi-4-multimodal (3,3) reste le seul modèle Phi qui comprend la parole, mais il date de février 2025 et les petites tailles de Gemma 4 sont désormais le meilleur choix.
Comment tester n'importe lequel d'entre eux
Les licences diffèrent au sein d'une même famille : Devstral Small 2 est sous Apache 2.0, Devstral 2 ne l'est pas. Lisez la fiche du checkpoint exact, vérifiez qu'il tient sur votre matériel, puis faites-le tourner sur vos propres tâches. Un petit nombre de paramètres vous dit ce que coûte son exécution, pas si ses réponses sont assez bonnes.